Im Jahr 1995 war ein „Browser“ eine Software mit genau einer Aufgabe: eine HTML-Datei über HTTP abzurufen und Text sowie Bilder auf den Bildschirm zu zeichnen. Dreißig Jahre später führt dieselbe Softwarekategorie den kollaborativen Echtzeit-Canvas von Figma aus, dekodiert 4K-Videos, simuliert Physik in WebGL/WebGPU-Spielen und führt Gigabytes an JavaScript pro Sitzung aus – wobei sie oft die nativen Desktop-Anwendungen übertrifft, die sie ersetzt hat. Diese Transformation geschah nicht zufällig. Sie entstand, weil eine Handvoll Entwicklerteams im Kampf um Marktanteile gezwungen war, Probleme auf Betriebssystemebene zu lösen: Prozessisolierung, Just-in-Time-Kompilierung, GPU-beschleunigtes Compositing und die Neugestaltung von Protokollen auf Transportschichtebene.
Dieser Artikel ist eine Analyse auf Systemebene darüber, wie der moderne Webbrowser – insbesondere die Chromium-Linie, die heute Chrome, Edge, Opera, Brave und Arc antreibt – praktisch zu einem Betriebssystem innerhalb deines Betriebssystems wurde.
1. Von Netscape zu Chromium: Der Browser wird zum Betriebssystem
Der erste und der zweite Browserkrieg
Der Erste Browserkrieg (1995–2001) stellte Netscape Navigator Microsofts Internet Explorer gegenüber. Microsofts Entscheidung, IE direkt in Windows zu bündeln – kostenlos, vorinstalliert und tief in die Betriebssystem-Shell integriert – war ein Vertriebsvorteil, den Netscapes lizenzbasiertes Geschäftsmodell niemals ausgleichen konnte. Bis 2002 beherrschte IE über 90 % des Marktes, der Quellcode von Netscape wurde als Mozilla-Projekt open-sourced und die Web-Innovation stagnierte unter der veralteten Rendering-Engine von IE6 für ein halbes Jahrzehnt praktisch vollständig.
Der Zweite Browserkrieg (2004–2008) war der Gegenangriff von Mozilla Firefox, der auf der Rendering-Engine Gecko basierte. Firefox brachte erneut Wettbewerbsdruck rund um Standardkonformität, Tabbed Browsing und Erweiterbarkeit ein und gewann bedeutende Marktanteile vom träge gewordenen IE zurück.
Im September 2008 veröffentlichte Google schließlich Chrome. Chrome brachte nicht nur eine schnellere JavaScript-Engine mit (V8, dazu unten mehr) – es führte ein grundlegend anderes Prozessmodell dafür ein, was ein Browser-Tab überhaupt ist. Die Rendering-Engine von Chrome begann als Fork von Apples WebKit (das selbst von KHTML abstammte); 2013 forkte Google WebKit zu Blink, und Blink ist seitdem das De-facto-Substrat des Webs geworden. Microsoft Edge gab 2020 seine eigene EdgeHTML-Engine zugunsten von Blink auf. Das Ergebnis ist ein Nahezu-Monopol, das oft als Chromium-Hegemonie bezeichnet wird: Die Mehrheit der Consumer-Browser teilt sich heute denselben Rendering-Kern und unterscheidet sich hauptsächlich in der Benutzeroberfläche und den Standard-Datenschutzeinstellungen.
Warum das für Entwickler wichtig ist: Da das Verhalten von Blink/V8 mittlerweile der De-facto-Webstandard ist und nicht nur eine Standardimplementierung, ist das Verständnis der Interna – und nicht nur des W3C-Spezifikationstextes – oft der Unterschied zwischen Code, der bloß funktioniert, und Code, der performant ist.
Vom Dokumentenbetrachter zur Anwendungs-Laufzeitumgebung
Die technischen Anforderungen an einen Browser skalierten um Größenordnungen, als sich das Web von statischen Dokumenten zu Anwendungen wandelte: AJAX (2005) verwandelte Seiten in zustandsbehaftete Clients, die Daten ohne Neuladen abriefen; das <canvas>-Element und spätere WebGL-APIs machten den Browser zu einem GPU-zugänglichen Rendering-Ziel; Node.js bewies, dass JavaScript serverseitig in großem Maßstab ausgeführt werden kann, was wiederum Investitionen in Browser-JS-Engines anregte; und Progressive Web Apps verwischten die Grenze zwischen „Website“ und „installierter Anwendung“ vollständig.
Ein Browser, der Google Docs, ein 3D-Multiplayer-Spiel und einen Live-Videocall gleichzeitig in verschiedenen Tabs ausführen kann, ist kein Dokumentenbetrachter. Er ist eine Multi-Tenant-Laufzeitumgebung, und er brauchte eine entsprechende Architektur.
Chromes architektonischer Durchbruch: Alles im Multiprozess-Betrieb
Browser vor Chrome waren weitgehend Single-Process, Multi-Threaded-Anwendungen. Jeder Tab, jede Erweiterung und die eigene Benutzeroberfläche des Browsers teilten sich einen einzigen Adressraum. Ein einziger fehlerhafter <script>-Tag, ein fehlerhaftes Plugin oder ein Renderer-Bug konnte alle geöffneten Tabs gleichzeitig zum Absturz bringen – und da alles den Speicher teilte, war ein Rendering-Bug in einem Tab ein potenzielles Sicherheitsrisiko für die Daten eines anderen Tabs.
Die grundlegende architektonische Entscheidung von Chrome war es, den Browser in zusammenarbeitende Prozesse auf Betriebssystemebene aufzuteilen:
- Browser-Prozess – der privilegierte Orchestrator. Besitzt die Benutzeroberfläche (Adressleiste, Lesezeichen, Tab-Leiste), verwaltet den Festplattencache und ist der einzige Prozess mit uneingeschränktem Zugriff auf das Netzwerk und das Dateisystem.
- Renderer-Prozesse – einer (oder mehrere) pro Tab/Website, auf denen Blink und V8 laufen. Diese sind bewusst gesandboxt: Ein Renderer-Prozess kann nicht direkt auf das Dateisystem zugreifen, keine beliebigen Systemaufrufe (Syscalls) durchführen und muss den Browser-Prozess über Inter-Prozess-Kommunikation (IPC) um privilegierte Aktionen bitten.
- GPU-Prozess – ein einzelner, gemeinsam genutzter Prozess, der den Grafikkontext besitzt und das Compositing durchführt. Er isoliert anfälligen, absturzgefährdeten GPU-Treibercode sowohl vom Browser als auch von den Renderern.
- Netzwerkprozess, Utility-Prozesse, Erweiterungsprozesse – weitere Aufteilung für Parsing, Audio und Erweiterungscode von Drittanbietern.
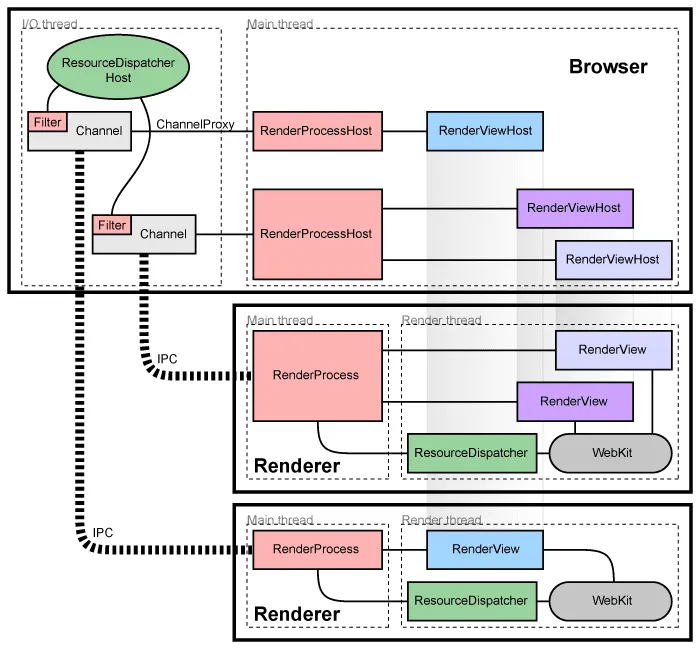
Abbildung 1: Multiprozess-Architektur von Chromium. Der Haupt-Browserprozess orchestriert Benutzeroberflächen- und Netzwerkoperationen und kommuniziert über Inter-Prozess-Kommunikationskanäle (IPC) mit isolierten, gesandboxten Renderer-Prozessen, um Sicherheitsgrenzen durchzusetzen.
Der unmittelbare, sichtbare Vorteil war die Absturzisolierung: Ein Tab konnte abstürzen – die berüchtigte „Oh nein!“ Seite – ohne die anderen zwanzig im Fenster geöffneten Tabs mitzureißen. Der tiefere Gewinn war die Sicherheit: Da Renderer-Prozesse gesandboxt und als nicht vertrauenswürdig behandelt werden, verschafft ein Fehler zur Remote-Code-Ausführung im HTML-Parser von Blink einem Angreifer nicht mehr die Kontrolle über das gesamte System. Stattdessen erhält der Angreifer nur einen isolierten Prozess mit fast keinen Privilegien, der dann noch einen zweiten, separaten Sandbox-Escape-Bug finden müsste, um echten Schaden anzurichten.
Site Isolation: Gehärteter Schutz nach Spectre
Die Multiprozess-Architektur allein reichte jedoch nicht aus. Ursprünglich gruppierte Chrome Tabs eher locker nach Prozessen (oft pro Tab, aber nicht strikt pro Origin). Das bedeutete, dass ein in trusted-bank.example eingebetteter <iframe> von evil.example immer noch denselben Renderer-Prozess – und damit denselben Adressraum – mit seiner übergeordneten Seite teilen konnte.
Die Offenlegung der Side-Channel-Sicherheitslücke Spectre im Jahr 2018 änderte diese Logik grundlegend. Spectre zeigte, dass ein bösartiges Skript durch Ausnutzung der spekulativen Ausführung des Prozessors potenziell beliebigen Speicher innerhalb seines eigenen Prozesses auslesen konnte. Sandbox-Isolierung auf Prozessebene reichte somit nicht mehr aus, wenn feindlicher und vertrauenswürdiger Code denselben Prozess teilten. Chromes Antwort darauf war Site Isolation: Jede eindeutige Site (grob gesagt: Schema + registrierbare Domain) erhält ihren eigenen Renderer-Prozess, selbst für Cross-Origin-iFrames, die in einer anderen Seite verschachtelt sind. Die prozessübergreifende Kommunikation zwischen einer Seite und ihren iFrames wird vollständig über IPC vermittelt, sodass es keinen gemeinsam genutzten Speicher gibt, den ein Auslesen im Spectre-Stil ausnutzen könnte.
Die Kosten der Isolierung: Site Isolation gibt es nicht umsonst. Eine Seite mit ein paar Dutzend Cross-Origin-Werbe- und Analytics-iFrames kann ein Dutzend zusätzliche Renderer-Prozesse starten, jeder mit seinem eigenen Speicher-Overhead (V8-Heap, Blinks DOM-Strukturen, IPC-Puffer). Dies ist der Hauptgrund, warum der RAM-Verbrauch von Chrome pro Tab oft kritisiert wird – es ist ein direkter, bewusster Kompromiss zwischen Speicherbedarf sowie Sicherheit und Stabilität.
2. Die V8-Engine: Eine dynamische Sprache schnell machen
JavaScript wurde 1995 in zehn Tagen als leichtgewichtige Skripting-Glue-Language entworfen. Sie ist dynamisch typisiert, verfügt über Garbage Collection und erlaubt es, Objektformen zur Laufzeit zu verändern – alles Eigenschaften, die einer schnellen Ausführung eher im Wege stehen. Googles V8-Engine, die erstmals mit Chrome ausgeliefert wurde, ist der Grund, warum JavaScript heute bei realen Workloads mit statisch kompilierten Sprachen konkurriert. Sie erreicht dies über eine dreistufige Pipeline: einen schnell startenden Interpreter, einen Mid-Tier-Compiler, der die Latenzlücke schließt, und einen spekulativen Optimierungscompiler auf oberster Stufe.
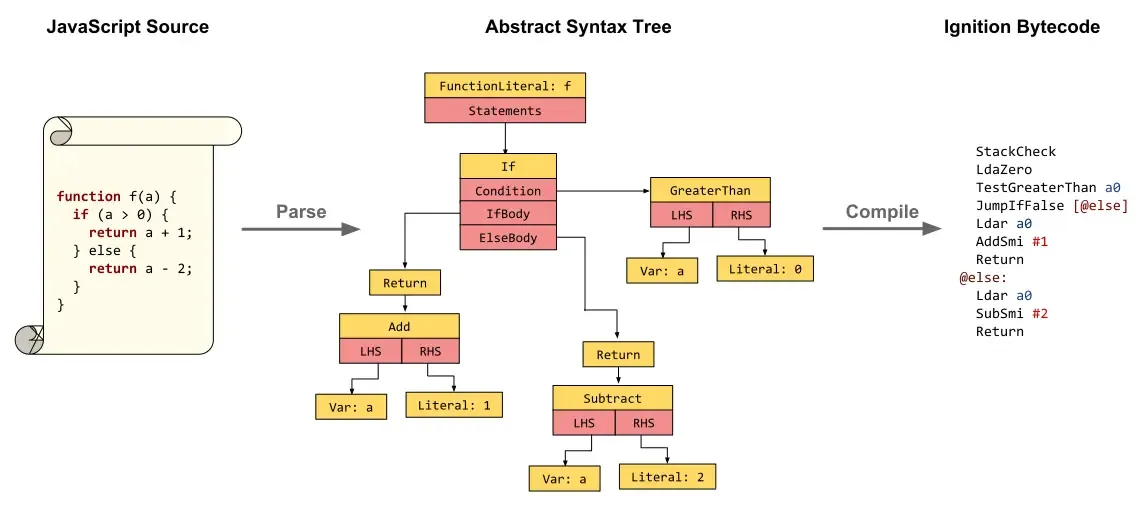
Abbildung 2: Die Parsing- und Bytecode-Generierungspipeline in V8. JavaScript-Quellcode wird in einen abstrakten Syntaxbaum (AST) geparst, den der Ignition-Interpreter vor der Ausführung direkt in registerbasierten Bytecode kompiliert.
Ignition: Der Bytecode-Interpreter
Wenn V8 Deinen JavaScript-Code erhält, kompiliert die Engine ihn nicht direkt in Maschinencode. Der Parser erstellt einen abstrakten Syntaxbaum (AST), und Ignition, der Interpreter von V8, kompiliert diesen AST in einen kompakten, registerbasierten Bytecode. Bytecode ist weitaus kleiner als entsprechender Maschinencode und kann nahezu augenblicklich generiert werden – was für die Ladezeit der Seite entscheidend ist, da Nutzer auf das erste Rendering (First Paint) warten.
Ignition führt diesen Bytecode direkt aus und nimmt während der Ausführung ein entscheidendes Profiling vor: Welche Funktionen werden häufig aufgerufen, welche Aufrufstellen sehen stabile Argumenttypen und welche Verzweigungen sind „hot“ (häufig durchlaufen). Diese Profiling-Daten sind der Treibstoff für die darüber liegenden Stufen.
Maglev: Überbrückung der Latenzlücke
Der Bytecode von Ignition bringt den Code zwar fast augenblicklich zum Laufen, aber ein Interpreter zahlt bei jeder einzelnen Ausführung einen Dispatch-Overhead pro Befehl – für eine zweimal aufgerufene Funktion ist das in Ordnung, für eine Funktion, die in einer Schleife zehntausendfach aufgerufen wird, jedoch verheerend. Die offensichtliche Lösung ist die direkte Kompilierung in nativen Maschinencode. Der Top-Tier-Compiler von V8, TurboFan, ist jedoch bewusst schwergewichtig: Er erstellt eine vollständige Graphdarstellung der Funktion und schickt sie durch eine lange Pipeline iterativer Optimierungsdurchläufe – Inlining, Escape-Analyse, Bereichsanalyse (Range Analysis), Load/Store-Eliminierung –, die hervorragenden Maschinencode auf Kosten von echter Kompilierungszeit und Speicher erzeugen. TurboFan auf jede Funktion anzusetzen, sobald sie nur leicht „warm“ wird, würde enorme CPU-Ressourcen verschwenden, um Code zu kompilieren, der vielleicht nur noch ein paar hundert Mal ausgeführt wird, bevor der Nutzer die Seite verlässt.
Maglev wurde entwickelt, um genau diese Lücke zu schließen. Als Mid-Tier-JIT-Compiler von V8 sitzt er in der Pipeline direkt zwischen Ignition und TurboFan. Anstatt einen schwergewichtigen Graphen aufzubauen und iterativ umzuschreiben, führt Maglev eine Single-Pass-Kompilierung direkt über Ignitions Bytecode durch. Dabei konstruiert er eine Static Single Assignment (SSA)-Darstellung – bei der jeder Variable genau einmal ein Wert zugewiesen wird, was die Datenflussanalyse vereinfacht – und wandelt diese in einem einzigen linearen Durchgang direkt in nativen Maschinencode um. Dadurch werden die iterativen Graph-Umschreibungen übersprungen, auf die TurboFan angewiesen ist. Das Ergebnis ist zwar nicht so aggressiv optimiert wie das von TurboFan, aber es handelt sich um echten nativen Maschinencode, der in einem Bruchteil der Zeit kompiliert wird und den interpretierten Bytecode mühelos abhängt.
Das gibt V8 eine gestufte Anlaufphase: Ignition führt eine Funktion ab ihrem allerersten Aufruf mit praktisch null Kompilierungslatenz aus; sobald sich die Funktion als etwas wärmer erweist, stuft V8 sie auf Maglev hoch, um günstigen, schnellen Maschinencode zu erhalten; und erst wenn sie sich als dauerhaft „hot“ erweist, tätigt V8 die wesentlich größere Investition, sie für eine maximale Optimierung an TurboFan zu übergeben.
Warum Multi-Tier-Kompilierung existiert: Kompilierung ist nicht kostenlos – sie konkurriert mit dem Rest der Seite um CPU-Zeit. Ein reiner Interpreter verschwendet Zyklen damit, dieselben Befehle Millionen Male neu zu verarbeiten; ein reiner Optimierungscompiler verschwendet Zyklen damit, Code tiefgreifend zu optimieren, der nie lange genug läuft, um seine eigenen Kompilierungskosten einzuspielen. Der einzige Existenzgrund von Maglev besteht darin, die Mitte dieser Kompromisskurve günstig zu machen, sodass die teuren Optimierungen von TurboFan nur dem Code vorbehalten bleiben, der statistisch bewiesen hat, dass er sie verdient.
TurboFan: Der optimierende Compiler
Sobald sich eine Funktion nicht nur als warm, sondern als dauerhaft hot erweist – also oft genug aufgerufen oder in Schleifen durchlaufen wurde, dass sich die höheren Kompilierungskosten von TurboFan um ein Vielfaches auszahlen –, übergibt V8 sie an TurboFan, den zuschaltbaren Top-Tier-JIT-Compiler. TurboFan nimmt das gesammelte Typ-Feedback von Ignition und Maglev und erzeugt den am aggressivsten optimierten nativen Maschinencode, den V8 produzieren kann. Dieser ist auf die tatsächlich beobachteten Typen spezialisiert – er nimmt beispielsweise an, dass der Parameter einer Funktion immer ein kleiner Integer ist, und eliminiert die generische Typprüfung sowie den Boxing/Unboxing-Overhead, den eine vollständig allgemeine Implementierung erfordern würde.
Dies ist im Wesentlichen eine spekulative Optimierung: TurboFan wettet darauf, dass das Typverhalten der Vergangenheit das Typverhalten der Zukunft vorhersagt. Wird diese Wette später verletzt – erhält eine Funktion, die immer Integer empfangen hat, plötzlich einen String –, muss V8 deoptimieren. Dabei wird der spezialisierte Maschinencode verworfen und die Ausführung fällt auf eine niedrigere Stufe zurück – Maglevs Code oder letztlich Ignitions Bytecode –, bevor der Code später möglicherweise mit breiteren Annahmen neu optimiert wird. Häufige Deoptimierung ist eine der häufigsten und unsichtbarsten Ursachen für Performance-Einbußen in JavaScript.
Deoptimierungs-Fallen: Polymorphe Aufrufstellen (eine Funktion, die mit vielen verschiedenen Argumentformen aufgerufen wird), das Mischen von Typen innerhalb eines einzelnen Arrays und das Ändern der Struktur eines Objekts nach seiner Erstellung gehören zu den häufigsten Wegen, V8 dazu zu zwingen, optimierte Pfade mitten in der Ausführung zu verwerfen.
Hidden Classes: Statische Struktur vortäuschen
Hier liegt das Kernproblem: In einer statisch typisierten Sprache weiß der Compiler bereits zur Kompilierzeit genau, wo sich jede Objekteigenschaft im Speicher befindet, sodass obj.x zu einem Auslesen mit festem Speicher-Offset kompiliert wird. In JavaScript sind Objekte dynamische Dictionaries – Eigenschaften können jederzeit hinzugefügt oder entfernt werden –, weshalb eine naive Implementierung für jeden einzelnen Eigenschaftszugriff einen Hash-Map-Lookup erfordern würde, was in großem Maßstab katastrophal langsam ist.
Die Lösung von V8 sind Hidden Classes (intern als Maps bezeichnet, nicht zu verwechseln mit dem JS-Typ Map). Jedem JavaScript-Objekt ist verdeckt eine Hidden Class zugeordnet, die seine aktuelle „Form“ (Shape) beschreibt: welche Eigenschaften es besitzt und an welchem Offset diese jeweils liegen. Wenn zwei Objekte erstellt werden, bei denen die Eigenschaften in der gleichen Reihenfolge hinzugefügt wurden, erkennt V8, dass sie dieselbe Form teilen, und weist ihnen dieselbe Hidden Class zu. Das bedeutet, dass der Eigenschaftszugriff nun wie in einer statischen Sprache zu einem direkten Offset-Auslesen kompiliert werden kann.
In dem Moment, in dem sich die Form eines Objekts ändert – eine neue Eigenschaft wird hinzugefügt oder gelöscht –, muss V8 es in eine neue Hidden Class überführen. Wenn zwei Konstruktoren logisch ähnliche Objekte bauen, die Eigenschaften aber in unterschiedlicher Reihenfolge zuweisen, generiert V8 völlig unterschiedliche Übergangsketten für die Hidden Classes, was diese Optimierung zunichte macht:
Inline Caching: Sich an die zuletzt gesehene Form erinnern
Hidden Classes lösen das Problem, wie ein Eigenschaftszugriff abläuft; Inline Caching (IC) löst das Problem, wie schnell er an einer bestimmten Stelle im Code erfolgt. Jede Stelle, an der auf eine Eigenschaft zugegriffen wird (eine „Aufrufstelle“, z. B. die konkrete Zeile obj.x), führt einen kleinen Cache. Dieser speichert, welche Hidden Class beim letzten Mal vorgefunden wurde und welcher Speicher-Offset daraus resultierte. Bei der nächsten Ausführung derselben Zeile prüft V8: „Ist die Hidden Class dieses Objekts dieselbe wie beim letzten Mal?“ Wenn ja, wird der Lookup komplett übersprungen und direkt zum gecachten Offset gesprungen.
Inline Caches durchlaufen drei Zustände:
- Monomorph – Die Aufrufstelle hat bisher nur eine einzige Hidden Class gesehen. Das ist der schnellstmögliche Pfad.
- Polymorph – Die Aufrufstelle hat eine kleine, begrenzte Anzahl unterschiedlicher Hidden Classes gesehen (V8 cacht mehrere davon und prüft jede einzelne). Immer noch recht schnell.
- Megamorph – Die Aufrufstelle hat zu viele verschiedene Formen gesehen, als dass sich ein Caching noch lohnen würde. V8 gibt den schnellen IC-Pfad auf und fällt auf einen generischen, deutlich langsameren Eigenschafts-Lookup zurück.
Genau deshalb raten Bibliotheken und Styleguides zu einer konsistenten Objekterstellung (feste Eigenschaften-Sets, einheitliche Einfügereihenfolge, Vermeidung von delete): Das ist kein Aberglaube, sondern dient dazu, Inline Caches monomorph zu halten.
3. Der Critical Rendering Path: Von Bytes zu Pixeln
Sobald V8 deine Skripte ausgeführt hat, muss der Browser das Dokument samt Styles immer noch in ein tatsächliches Bild auf dem physischen Bildschirm verwandeln – idealerweise 60 (oder 120) Mal pro Sekunde. Diese Pipeline – der Critical Rendering Path – ist der Ort, an dem Netzwerk-Bytes zu Pixeln werden.
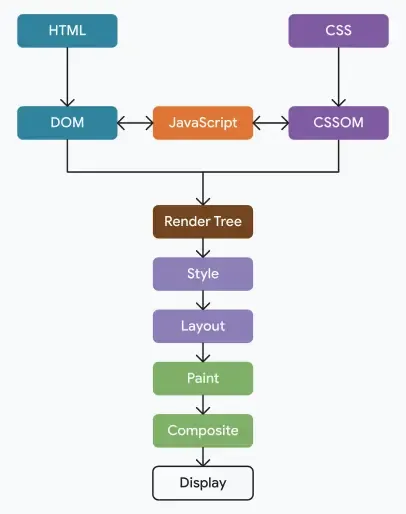
Abbildung 3: Die Critical Rendering Path-Pipeline. Der Browser parst HTML und CSS in die DOM- und CSSOM-Bäume, führt sie in einem Render Tree zusammen und führt Layout-, Paint- und Compositing-Durchläufe aus, um den finalen Frame auf dem Bildschirm zu rendern.
DOM- und CSSOM-Konstruktion
Sobald HTML-Bytes eintreffen, tokenisiert der HTML-Parser von Blink diese inkrementell und baut den DOM (Document Object Model)-Baum auf – eine lebendige, strukturierte Repräsentation jedes Elements und Textknotens. Das Parsing ist von Grund auf als Streaming und inkrementell konzipiert: Der Browser wartet nicht auf das gesamte Dokument, bevor er mit dem Aufbau des Baums beginnt. Deshalb läuft ein Preload Scanner dem Hauptparser voraus, der <img>-, <link>- und <script>-Tags frühzeitig erkennt, um Netzwerkanfragen zu starten, noch bevor der Parser sie überhaupt erreicht.
Parallel dazu wird CSS – egal ob aus <style>-Blöcken oder verlinkten Stylesheets – in das CSSOM (CSS Object Model) geparst, einen Baum aus Style-Regeln mit berechneter Spezifität und Kaskadenauflösung. Die CSSOM-Konstruktion ist render-blocking (render-blockierend): Da jede spätere Stylesheet-Regel prinzipiell eine frühere überschreiben könnte, kann der Browser nicht sicher mit dem Zeichnen (Painting) beginnen, bevor ihm das vollständige CSSOM vorliegt (das ist auch der Grund für den klassischen Performance-Rat, Stylesheets klein zu halten und früh zu laden).
Render Tree, Layout und Paint
Sobald DOM und CSSOM verfügbar sind, kombiniert Blink diese zum Render Tree: im Wesentlichen der DOM, jedoch gefiltert auf nur diejenigen Knoten, die tatsächlich sichtbar sein werden (display: none-Elemente werden vollständig ausgeschlossen, während visibility: hidden-Elemente enthalten sind, da sie weiterhin Platz einnehmen), versehen mit ihren finalen berechneten Styles.
Der Render Tree weiß nur, was gezeichnet werden soll, nicht wo. Layout (manchmal auch Reflow genannt) durchläuft den Baum und berechnet die genaue Box-Modell-Geometrie – Position, Breite, Höhe, Ränder – für jeden einzelnen Knoten relativ zum Viewport. Dies ist von Natur aus eine globale Operation: Die Änderung der Breite eines Elements kann sich fortpflanzen und die Position jedes Geschwister- und Unterelements verschieben. Deshalb ist das Layout eine der teuersten Phasen in der Pipeline und das wiederholte Auslösen in einer engen Schleife (Layout Thrashing, z. B. durch abwechselndes Auslesen von offsetHeight und Schreiben eines Styles) ein klassisches Performance-Anti-Pattern.
Sobald die Geometrie feststeht, rastert Paint jedes sichtbare Element in tatsächliche Pixel – füllt Text, Farben, Rahmen, Schatten und Bilder – und zeichnet dies als geordnete Liste von Zeichenbefehlen (Rechtecke, Glyphenläufe, Image-Blits) pro Ebene (Layer) auf.
Compositing: Übergabe an die GPU
Die letzte Phase, das Compositing, ermöglicht butterweiches Scrollen und geschmeidige Animationen. Bestimmte Elemente – solche mit einem CSS-transform, einer opacity-Transition, einem will-change-Hinweis, <video> oder <canvas> – werden auf eine eigene Compositor-Ebene (Compositor Layer) angehoben, im Grunde eine separate Textur. Diese Ebenen werden an den GPU-Prozess übergeben, der sie auf einem dedizierten Compositor-Thread zusammenfügt – völlig getrennt vom Hauptthread für JavaScript, Layout und Paint.
Der Gewinn: Die Animation von transform und opacity kann Layout und Paint komplett überspringen und wird rein von der GPU verarbeitet, die bereits gerasterte Texturen neu positioniert. Deshalb können diese beiden Eigenschaften selbst dann flüssige 60/120 FPS erreichen, wenn der Hauptthread gerade intensiv mit JavaScript beschäftigt ist. Die Animation von width, top oder left hingegen erzwingt bei jedem einzelnen Frame einen vollständigen Durchlauf von Layout → Paint → Composite, da sich die Geometrie selbst ändert.
will-change ist ein Skalpell, kein Hammer: Das Anheben eines Elements auf eine eigene Compositor-Ebene verbraucht GPU-Speicher (jede Ebene ist eine vollständige Textur). Die übermäßige Verwendung von will-change bei vielen Elementen kann die Performance beeinträchtigen, da der GPU-Speicher erschöpft wird und ein übermäßiges Layer-Management erzwungen wird – es sollte gezielt eingesetzt werden, direkt bevor eine Animation startet, und danach wieder entfernt werden.
4. Netzwerkprotokolle als Treiber des Webs: Von HTTP/1.1 zu HTTP/3
Schnelles Rendering nützt nichts, wenn die Bytes zu lange brauchen, um anzukommen. Die Transportschicht unterhalb des Browsers hat ein ebenso radikales Redesign erfahren wie die Rendering-Engine selbst.
HTTP/1.1 und das Head-of-Line-Blocking-Problem
HTTP/1.1 ist ein Klartext-Anfrage-Antwort-Protokoll (Request-Response-Protokoll), bei dem streng genommen pro TCP-Verbindung immer nur eine Anfrage gleichzeitig offen sein kann (Pipelining – das Senden mehrerer Anfragen, ohne auf Antworten zu warten – war technisch zwar erlaubt, wurde von Intermediären jedoch so schlecht und uneinheitlich implementiert, dass Browser es nie standardmäßig aktivierten). Um dennoch Parallelität zu erreichen, griffen Browser darauf zurück, mehrere gleichzeitige TCP-Verbindungen pro Origin zu öffnen – typischerweise auf etwa sechs begrenzt. Ein Hack, der zwar funktioniert, aber mit echten Kosten verbunden ist: Jede Verbindung benötigt ihren eigenen TCP-Handshake und unter HTTPS ihren eigenen TLS-Handshake, und jede beginnt mit einem langsamen initialen Staufenster (Congestion Window).
HTTP/2: Multiplexing über eine einzelne Verbindung
HTTP/2 ersetzte das Klartext-Framing von HTTP/1.1 durch einen Binär-Framing-Layer, der Anfragen und Antworten in kleine Frames zerlegt, die mit einer Stream-ID versehen und alle über eine einzige TCP-Verbindung verschachtelt werden. Dies ermöglicht echtes Multiplexing: Dutzende Anfragen und Antworten können gleichzeitig über eine Verbindung verarbeitet werden („in flight“ sein), was den Sechs-Verbindungen-Workaround und den damit verbundenen redundanten Handshake-Overhead überflüssig macht. HTTP/2 führte außerdem die Header-Komprimierung HPACK ein (da HTTP-Header bei Anfragen an dieselbe Origin extrem repetitiv sind) sowie – kontroverser – Server Push (in der Praxis bis 2022 weitgehend aufgegeben, da es sich als schwer abzustimmen erwies und oft von einfacheren Techniken wie <link rel="preload"> übertroffen wurde).
HTTP/2 löste das Head-of-Line-Blocking auf Anwendungsebene – erbte jedoch ein tiefer liegendes Problem von seinem Transportprotokoll. TCP garantiert eine strikt geordnete Auslieferung der Bytes in korrekter Reihenfolge. Wenn ein einzelnes Paket irgendwo in dieser einen gemeinsam genutzten TCP-Verbindung verloren geht, gerät jeder multiplexte HTTP/2-Stream ins Stocken (Stall). TCP übergibt den Empfangspuffer des Kernels erst dann an die Anwendung, wenn das fehlende Paket erneut übertragen wurde und der Byte-Stream wieder in Reihenfolge ist – selbst wenn das verlorene Paket nur zu einem einzigen der Dutzenden aktiven Streams gehörte. Das ist Head-of-Line-Blocking auf Transportschichtebene, und keine noch so kluge Logik auf Anwendungsebene kann dies beheben, solange TCP das zugrundeliegende Transportprotokoll ist.
HTTP/3: Abkehr von TCP zugunsten von QUIC
Die entscheidende Neuerung von HTTP/3 ist radikal: Es verzichtet vollständig auf TCP und läuft über QUIC, ein neues Transportprotokoll, das auf UDP aufbaut. Das klingt zunächst nach einem Rückschritt – UDP bietet keinerlei Garantien für Reihenfolge oder Zuverlässigkeit –, aber genau das ist der Punkt. QUIC implementiert Zuverlässigkeit und Überlaststeuerung (Congestion Control) selbst auf der Transportschicht, aber entscheidenderweise pro Stream und nicht für die Verbindung als Ganzes. Wenn ein Paket mit Daten für Stream 4 verloren geht, gerät nur Stream 4 beim Warten auf die erneute Übertragung ins Stocken; die Streams 1, 2 und 3 liefern weiterhin ununterbrochen Daten an die Anwendung. Head-of-Line-Blocking ist nun auf den einzelnen Stream beschränkt, der tatsächlich Daten verloren hat, und betrifft nicht mehr die gesamte Verbindung.
QUIC führt außerdem den Transport- und den kryptografischen Handshake zusammen. Während TCP + TLS 1.3 historisch einen TCP-Handshake gefolgt von einem separaten TLS-Handshake erforderte (was zusätzliche Roundtrips erzeugte), integriert QUIC TLS 1.3 direkt in seinen eigenen Handshake. Bei wiederholten Verbindungen zu einem Server, den der Client kürzlich besucht hat, unterstützt es 0-RTT-Wiederaufnahme (0-RTT Resumption): Der Client kann verschlüsselte Anwendungsdaten direkt mit dem allerersten Paketstoß senden und dabei kryptografische Parameter nutzen, die aus der vorherigen Sitzung zwischengespeichert wurden – ohne überhaupt auf einen Server-Roundtrip warten zu müssen, bevor nützliche Daten fließen. (0-RTT-Daten bergen ein theoretisches Risiko für Replay-Attacken, weshalb Server einschränken, welche Arten von Anfragen – typischerweise idempotente – diese nutzen dürfen.)
Ein weiteres, oft unterschätztes QUIC-Feature ist Connection Migration: Da eine QUIC-Verbindung über eine Connection ID und nicht über das traditionelle TCP-4-Tupel (Quell-IP, Quell-Port, Ziel-IP, Ziel-Port) identifiziert wird, kann ein Client das Netzwerk wechseln – etwa von WLAN zu mobilen Daten, wenn man das Haus verlässt –, ohne dass die Verbindung abgebrochen und neu aufgebaut werden muss.
| Eigenschaft | HTTP/1.1 | HTTP/2 | HTTP/3 |
|---|---|---|---|
| Transport | TCP | TCP | QUIC über UDP |
| Multiplexing | Keine (erfordert mehrere Verbindungen) | Ja, einzelne Verbindung | Ja, pro Stream |
| Head-of-Line-Blocking | Schwerwiegend (pro Verbindung) | Nur auf Transportebene (ein verlorenes Paket lässt alle Streams stocken) | Eliminiert (pro Stream isoliert) |
| Header-Komprimierung | Keine | HPACK | QPACK |
| Handshake | TCP + separater TLS-Handshake | TCP + separater TLS-Handshake | Kombinierter Transport- + Krypto-Handshake |
| 0-RTT-Wiederaufnahme | Nein | Nein | Ja |
| Connection Migration | Nein (gebunden an IP/Port) | Nein (gebunden an IP/Port) | Ja (basiert auf Connection ID) |
UDP ist nicht überall willkommen: Da QUIC über UDP läuft, wird es von einigen Unternehmens-Firewalls, älteren Middleboxes und restriktiven Netzwerken gedrosselt oder direkt blockiert, da diese historisch darauf ausgelegt waren, TCP zu priorisieren oder ausschließlich zu erwarten. Browser lösen dies, indem sie HTTP/3 immer opportunistisch versuchen und transparent auf HTTP/2 über TCP zurückgreifen, wenn UDP nicht verfügbar ist – ein Pfad für Graceful Degradation, der direkt im Client verankert sein muss.
5. Fazit: WebAssembly und das Schließen der Lücke zur nativen Performance
Jede bisher behandelte Schicht – die gesandboxte Multiprozess-Architektur, der spekulative JIT-Compiler von V8, die GPU-beschleunigte Rendering-Pipeline und das latenzarme QUIC-Transportprotokoll – wurde im Dienste eines einzigen Ziels entwickelt: den Browser wie eine Anwendungsplattform erster Klasse agieren zu lassen. Die letzte große Lücke war der reine Rechendurchsatz für anspruchsvollste Workloads: Video- und Bildbearbeitungssuiten, CAD-Werkzeuge, vollständige 3D-Game-Engines und wissenschaftliches Rechnen, wo selbst der optimierte Maschinencode von V8 einen verbleibenden Overhead durch dynamische Typprüfungen und Garbage-Collection-Pausen in JavaScript aufweist.
WebAssembly (Wasm) schließt diese Lücke. Es ist ein kompaktes, binäres Befehlsformat, das als Kompilierungsziel und nicht als manuell zu schreibende Sprache konzipiert wurde – Code in C, C++, Rust und Go kann direkt in Wasm-Module kompiliert werden, die im selben gesandboxten Renderer-Prozess laufen. Dies geschieht mit Geschwindigkeiten nahe an nativem Maschinencode, da Wasm statisch typisiert ist und im Voraus validiert wird. Dadurch wird der Overhead der dynamischen Typisierung umgangen, um den JavaScript-Engines spekulieren müssen. Wasm-Module teilen sich einen linearen Speicherpuffer mit JavaScript und werden über schlanken JS-Glue-Code aufgerufen. Dadurch können bestehende native Codebasen – eine Physik-Engine, ein Videocodec, ein CAD-Kernel – weitgehend unverändert in den Browser integriert werden.
So führt Figma eine C++-Rendering-Engine in einem Tab aus, so liefern AutoCAD und Photoshop Browser-Versionen mit echter Bearbeitungsleistung aus und so können Unreal Engine und Unity das Web als Build-Ziel für spielbare Game-Demos ansteuern. Neue Bestrebungen wie das WebAssembly System Interface (WASI) tragen das gesandboxte, portable Ausführungsmodell von Wasm nun vollständig außerhalb des Browsers – in Edge-Computing und serverseitige Laufzeitumgebungen. Damit wird eine Technologie, die zur Lösung eines Browser-Performance-Problems geboren wurde, zu einem universellen, sicheren Ausführungsformat für die gesamte Datenverarbeitung.
Dreißig Jahre nachdem Netscape einen Dokumentenbetrachter veröffentlichte, ist der „Browser“ wohl das anspruchsvollste Stück Software für Endanwender, das die meisten Menschen ausführen: ein Betriebssystem im wahrsten ingenieurtechnischen Sinne, das sich zufällig in einem Rechteck auf Deinem Bildschirm rendert.
Referenzen & weiterführende Literatur
- V8 Development Team. Firing up the Ignition interpreter. V8.dev. Technischer Hintergrund zum Bytecode-Design von Ignition und seiner Rolle für die Start-Performance von V8.
- V8 Development Team. TurboFan JIT Design. V8.dev. Architekturdokumentation über den optimierenden Compiler von V8 und das Modell der spekulativen Optimierung.
- Chromium Project. Site Isolation Design Documents. Chromium.org. Technische Begründung für die Renderer-Prozessisolierung pro Website nach der Aufdeckung von Spectre.
- IETF. RFC 9000: QUIC — A UDP-Based Multiplexed and Secure Transport. IETF Datatracker. Die formelle QUIC-Transportspezifikation, die HTTP/3 zugrunde liegt.
- IETF. RFC 9114: HTTP/3. IETF Datatracker. Die formelle Abbildung von HTTP-Semantiken auf das QUIC-Transportprotokoll.
- web.dev (Google). Critical Rendering Path. web.dev. Referenzdokumentation zu DOM/CSSOM-Konstruktion, Layout, Paint und Compositing.
- WebAssembly Community Group. WebAssembly.org. Offizielle Spezifikations-Zentrale und Entwurfsbegründung für das binäre Befehlsformat von Wasm.
Technisches Glossar
| Begriff | Definition |
|---|---|
| Blink | Googles HTML/CSS-Rendering-Engine, 2013 von WebKit geforkt, wird heute von Chrome, Edge, Opera und den meisten anderen Chromium-basierten Browsern genutzt. |
| Site Isolation | Eine Sicherheitsarchitektur von Chromium, die jeder separaten Website (einschließlich Cross-Origin-iFrames) einen eigenen Renderer-Prozess zuweist, um vor Speicher-Leseangriffen der Spectre-Klasse zu schützen. |
| Ignition | Der Bytecode-Interpreter von V8, der für die schnelle Ausführung beim Starten und das Sammeln von Typ-Feedback-Profiling-Daten verantwortlich ist. |
| TurboFan | Der optimierende JIT-Compiler von V8, der spekulativ typspezialisierten nativen Maschinencode für „hot“ Funktionen erzeugt. |
| Hidden Class (Map) | Die interne Repräsentation der Objektform („Shape“) eines JavaScript-Objekts in V8, die einen offsetbasierten Eigenschaftszugriff wie in statischen Sprachen ermöglicht. |
| Inline Cache (IC) | Ein Cache pro Aufrufstelle, der sich die zuletzt beobachteten Hidden Classes merkt, sodass V8 bei wiederholter Ausführung vollständige Eigenschafts-Lookups überspringen kann. |
| CSSOM | Das CSS Object Model – eine Baumdarstellung geparster Stylesheet-Regeln, die zusammen mit dem DOM den Render Tree bildet. |
| Compositor Thread | Ein dedizierter Thread, getrennt vom Hauptthread für JS/Layout, der das GPU-Ebenen-Compositing für flüssige Animationen unabhängig von der Hauptthread-Auslastung übernimmt. |
| Head-of-Line Blocking | Ein Blockierungszustand, bei dem der Verlust oder die Verzögerung einer Dateneinheit die Auslieferung unbeteiligter, über denselben Kanal multiplexter Daten blockiert. |
| QUIC | Ein UDP-basiertes Transportprotokoll (RFC 9000), das Zuverlässigkeit pro Stream, integrierte TLS 1.3-Handshakes, 0-RTT-Wiederaufnahme und Connection Migration bietet. |
| 0-RTT Resumption | Ein Feature von QUIC/TLS 1.3, das es einem wiederkehrenden Client ermöglicht, bereits mit dem allerersten Paketstoß verschlüsselte Anwendungsdaten zu senden, ohne auf einen Server-Roundtrip zu warten. |
| WebAssembly (Wasm) | Ein statisch typisiertes, gesandboxtes binäres Befehlsformat, das als Kompilierungsziel für eine nahezu native Performance innerhalb der Browser-Laufzeitumgebung dient. |