1995年当時、「ブラウザ」とは単一のタスクを担うソフトウェアでした。HTTP経由でHTMLファイルを取得し、テキストと画像をキャンバスに描画することです。それから30年が経過した現在、同じカテゴリのソフトウェアがFigmaのリアルタイム共同編集キャンバスを動かし、4Kビデオをデコードし、WebGL/WebGPUゲームで物理シミュレーションを実行し、1セッションあたり数ギガバイトのJavaScriptを処理しています。これは、置き換えたはずのネイティブデスクトップアプリケーションのパフォーマンスを凌駕することも珍しくありません。この変革は偶然起きたものではありません。市場シェアを巡って争う一握りのエンジニアリングチームが、プロセス分離、JIT(Just-In-Time)コンパイル、GPUアクセラレーションによるコンポジット、トランスポート層プロトコルの再設計といった、OSレベルの課題の解決を余儀なくされた結果なのです。
この記事では、現代のブラウザ(特に現在Chrome、Edge、Opera、Brave、Arcの動力源となっているChromiumの系譜)が、実質的にいかにして「OSの上で動作するオペレーティングシステム」へと進化したのかを、システムレベルの視点から解剖していきます。
1. ネットスケープからChromiumへ:ブラウザはOSになる
第1次・第2次ブラウザ戦争
第1次ブラウザ戦争(1995年〜2001年)は、Netscape NavigatorとMicrosoftのInternet Explorerとの戦いでした。IEをWindowsに直接同梱し、無料でプリインストールし、OSのシェルと深く統合するというMicrosoftの決定は、ライセンス販売に基づくNetscapeのビジネスモデルでは決して対抗できない配信上の圧倒的優位性をもたらしました。2002年までにIEは市場の90%以上を支配するようになり、NetscapeのコードベースはMozillaプロジェクトとしてオープンソース化され、ウェブの革新は停滞したIE6のレンダリングエンジンの下で実質的に半世紀近く足踏みすることになりました。
第2次ブラウザ戦争(2004年〜2008年)は、Geckoレンダリングエンジンをベースに構築されたMozilla Firefoxによる反撃でした。Firefoxは標準準拠、タブブラウジング、拡張性といった面で再び競争の圧力をもたらし、高く括っていたIEから意味のある市場シェアを奪い返しました。
そして2008年9月、GoogleがChromeをリリースしました。Chromeは単に高速なJavaScriptエンジン(後述のV8)をもたらしただけでなく、ブラウザの「タブ」という存在そのもののプロセスモデルを根本から覆しました。ChromeのレンダリングエンジンはAppleのWebKit(それ自体はKHTMLに由来)のフォークとしてスタートしましたが、2013年にGoogleはWebKitをフォークしてBlinkを作成し、Blinkはそれ以来ウェブの事実上の基盤(デファクトスタンダード)となりました。Microsoft Edgeも2020年に独自のEdgeHTMLエンジンを破棄し、Blinkを採用しました。その結果、しばしばChromiumによる覇権と呼ばれるほぼ独占状態が生み出されました。今日の一般向けブラウザの大部分は同じレンダリングコアを共有しており、主な違いはUIシェル(UI chrome)やデフォルトのプライバシー設定程度に留まっています。
エンジニアにとってこれが重要な理由: Blink/V8の挙動は、単なる実装仕様の「1つ」ではなく、現在では事実上のウェブ標準となっているため、単にW3C仕様のテキストを読むだけでなく、その内部構造を理解することが、「単に動くコード」と「パフォーマンスの高いコード」の違いを生むことがよくあります。
ドキュメントビューアからアプリケーションランタイムへ
ウェブが静的なドキュメントからアプリケーションへと移行するにつれ、ブラウザに求められる技術的要件は桁違いに増大しました。AJAX(2005年)はページをリロードなしでデータを取得するステートフルなクライアントへと変え、<canvas>やその後のWebGL APIはブラウザをGPUアクセス可能なレンダリングターゲットへと変貌させました。Node.jsはJavaScriptがサーバーサイドで大規模に動作することを証明し、それがブラウザのJSエンジンへの投資へと還元され、Progressive Web Apps(PWA)は「ウェブサイト」と「インストールされたアプリ」の境界線を完全に曖昧にしました。
Google ドキュメント、マルチプレイヤー3Dゲーム、ライブビデオ通話を異なるタブで同時に実行できるブラウザは、もはや単なるドキュメントビューアではありません。それはマルチテナントなランタイム環境であり、それに適したアーキテクチャが必要でした。
Chromeのアーキテクチャ上の勝利:あらゆるものをマルチプロセス化
Chrome以前のブラウザは、主に単一プロセス・マルチスレッドのアプリケーションでした。すべてのタブ、拡張機能、ブラウザ自身のUIが一つのアドレス空間を共有していました。単一の不正な<script>タグ、バグのあるプラグイン、あるいはレンダラーのバグが、開いているすべてのタブを同時にクラッシュさせる可能性があり、すべてがメモリを共有していたため、あるタブのレンダリングバグは別のタブのデータへの潜入を許すセキュリティ上の抜け道になり得ていました。
Chromeの根本的なアーキテクチャ上の決定は、ブラウザを協調して動作するOSレベルのプロセス群に分割することでした。
- ブラウザプロセス(Browser Process) — 特権を持つオーケストレーター。UI(アドレスバー、ブックマーク、タブバー)を所有し、ディスクキャッシュを管理し、ネットワークやファイルシステムへの無制限アクセスを持つ唯一のプロセス。
- レンダラープロセス(Renderer Process) — タブ/サイトごとに1つ(または複数)割り当てられ、BlinkとV8を実行。これらは意図的にサンドボックス化されており、レンダラープロセスはファイルシステムに直接触れることも、任意のスシテムコール(syscalls)を実行することもできず、特権が必要な処理はすべてプロセス間通信(IPC)を介してブラウザプロセスに要求しなければなりません。
- GPUプロセス(GPU Process) — グラフィックスコンテキストを所有しコンポジットを実行する単一の共有プロセス。クラッシュしやすい脆弱なGPUドライバコードを、ブラウザとレンダラーの両方から分離・隔離します。
- ネットワークプロセス、ユーティリティプロセス、拡張機能プロセス — パース処理、音声、サードパーティ製拡張機能コードなどをさらに細分化したプロセス。
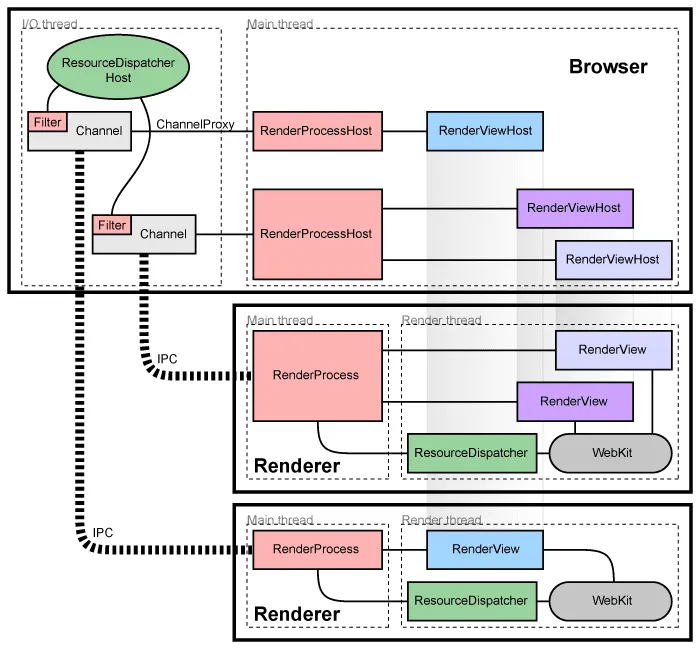
図1:Chromiumのマルチプロセスアーキテクチャ。メインのブラウザプロセスがUIとネットワーク操作を統括し、セキュリティ境界を適用するためにプロセス間通信(IPC)チャネルを介して分離されたサンドボックス内のレンダラープロセスと通信します。
すぐに目に見えた利点はクラッシュの局所化でした。1つのタブがクラッシュしても(あの悪名高い「エラーが発生しました」ページ)、ウィンドウで開いている他の20個のタブを巻き添えにすることはなくなりました。より深い利点はセキュリティでした。レンダラープロセスはサンドボックス化され信頼できないものとして扱われるため、BlinkのHTMLパーサーにリモートコード実行のバグがあっても、攻撃者にマシン全体の権限を与えることにはなりません。与えられるのは実質的に権限のないサンドボックス化されたプロセスであり、危害を加えるには2つ目の独立したサンドボックス回避バグを見つける必要があります。
サイト分離(Site Isolation):Spectre以降のセキュリティ強化
マルチプロセスアーキテクチャだけでは不十分でした。当初、Chromeはプロセスによるタブのグループ化をやや緩やかに行っており(多くはタブ単位ですが、厳密なオリジン単位ではありませんでした)、trusted-bank.exampleの中に埋め込まれたevil.exampleからの<iframe>が、親ページとレンダラープロセス(ひいてはアドレス空間)を共有する可能性がありました。
2018年に開示された投機的実行のサイドチャネル攻撃の脆弱性Spectreは、この前提を完全に変えました。Spectreは、悪意のあるスクリプトがCPUの投機的実行を悪用することで、自身プロセス内の任意のメモリを読み取れる可能性を示しました。つまり、敵対的なコードと信頼できるコードがプロセスを共有している場合、プロセスレベルのサンドボックス化だけではもはや不十分となったのです。Chromeの対策は**サイト分離(Site Isolation)**でした。これにより、別のページにネストされたクロスオリジンのiframeであっても、異なるサイト(大まかには、スキーム + 登録可能ドメイン)ごとに独自のレンダラープロセスが割り当てられるようになりました。ページとそのiframe間のプロセス間通信は完全にIPCを介して行われるため、Spectre型の読み取りで悪用できる共有メモリは存在しません。
分離の代償: サイト分離はタダではありません。クロスオリジンの広告やアナリティクスのiframeが12個あるページでは、さらに12個のレンダラープロセスが立ち上がり、それぞれが固有の基本メモリオーバーヘッド(V8ヒープ、BlinkのDOM構造、IPCバッファ)を消費します。これが、ChromeのタブごとのRAM使用量がしばしば批判される最大の理由です。これはセキュリティと安定性のためにメモリをトレードオフした直接的かつ意図的な設計なのです。
2. V8エンジン:動的言語を高速化する技術
JavaScriptは1995年、軽量なスクリプト言語(接着剤言語)としてわずか10日間で設計されました。動的型付け、ガベージコレクション、実行時におけるオブジェクト形状の動的変更といった特性を備えており、これらは本来、高速な実行には適さない性質ばかりです。GoogleがChromeで初めて導入したV8エンジンは、JavaScriptが実際のワークロードにおいて静的コンパイル言語と肩を並べられるようになった最大の理由です。V8はこれを、高速に起動するインタプリタ、レイテンシのギャップを埋める中位コンパイラ、そして投機的最適化を行う上位コンパイラという3段階のパイプラインによって実現しています。
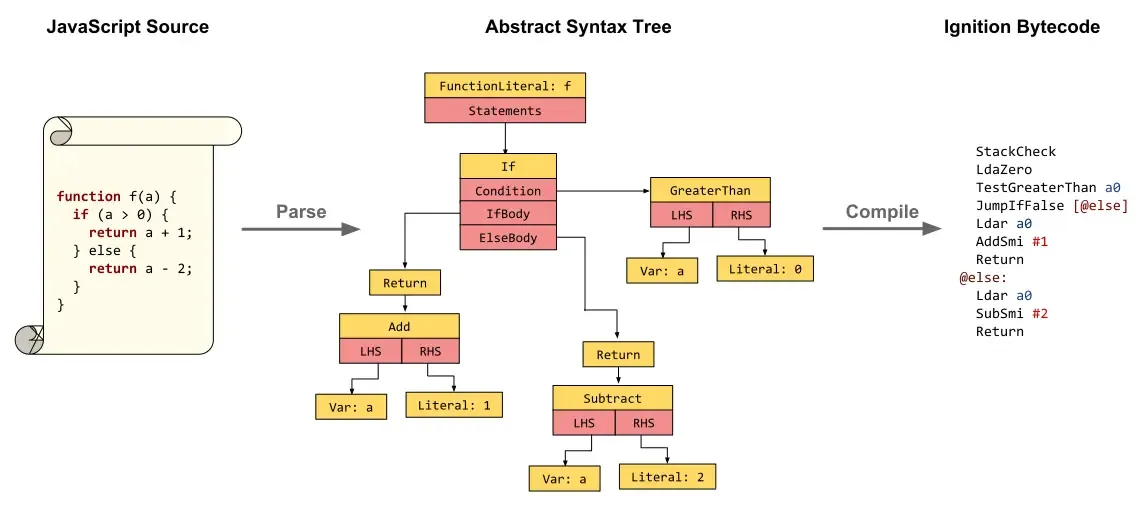
図2:V8におけるパースおよびバイトコード生成パイプライン。JavaScriptのソースコードは抽象構文木(AST)にパースされ、これをIgnitionインタプリタが実行前にレジスタベースのバイトコードへ直接コンパイルします。
Ignition:バイトコードインタプリタ
V8がJavaScriptを受け取ると、最初から直接マシンコードへコンパイルするわけではありません。まずパーサーが抽象構文木(AST)を構築し、V8のインタプリタであるIgnitionがそのASTをコンパクトなレジスタベースのバイトコードへとコンパイルします。バイトコードは同等のマシンコードよりもはるかに小さく、ほぼ瞬時に生成できるため、ユーザーが初回描画(ファーストペイント)を待つページロード性能において決定的に重要となります。
Ignitionはこのバイトコードを直接実行すると同時に、非常に重要な役割として実行時のプロファイリングも行います。どの関数が頻繁に呼び出されているか、どの呼び出し元(call site)の引数型が安定しているか、どの分岐がホットかといった情報です。このプロファイリングデータが、上位層のパイプラインを駆動する燃料となります。
Maglev:レイテンシギャップの架け橋
Ignitionのバイトコードはコードをほぼ瞬時に実行開始できますが、インタプリタは命令を実行するたびにディスパッチのオーバーヘッドを支払うことになります。数回呼び出される程度の関数なら問題ありませんが、ホットなループ内で数万回呼び出されるような関数では壊滅的です。明白な解決策はネイティブマシンコードへ直接コンパイルすることですが、V8の最上位コンパイラであるTurboFanは意図的にヘビーウェイトに設計されています。関数の完全なグラフ表現を構築し、インライン化、エスケープ解析、範囲解析、ロード/ストアの削減といった一連の反復的な最適化パスを実行するため、優れたマシンコードを生成できる反面、相応のコンパイル時間とメモリを消費します。ほんの少し「温まった(warm)」程度の関数すべてに対してTurboFanを起動してしまうと、ページ遷移までに数回程度しか実行されないかもしれないコードのコンパイルに、膨大なCPUリソースを浪費することになります。
Maglevはそのギャップを埋めるために存在します。V8の中位JITコンパイラとして導入されたMaglevは、パイプライン上でIgnitionとTurboFanのちょうど中間に位置します。ヘビーウェイトなグラフを構築して反復的に書き換える代わりに、MaglevはIgnitionのバイトコードに対して単一パス(1-pass)コンパイルを実行します。すべての変数に一度だけ値が代入される**静的単一代入(SSA)**表現を構築してデータフロー解析を単純化し、それを1回の線形パスでネイティブマシンコードへ直接降ろす(lowering)ことで、TurboFanが依存している複数回のグラフ書き換え処理をスキップします。生成されるコードはTurboFanほどアグレッシブに最適化されていませんが、わずかな時間でコンパイルされた本物のネイティブマシンコードであり、解釈実行されるバイトコードを圧倒するスピードを発揮します。
これにより、V8は段階的なアクセラレーションを実現しています。初回呼び出し時にはIgnitionが実質ゼロのコンパイルレイテンシで関数を実行し、関数が「温まった」と判断されるとV8はそれをMaglevへ昇格させて低コストかつ高速なネイティブコードを得ます。そして、真に持続的に「ホット」であると証明された場合にのみ、最大級の最適化を行うためにTurboFanへの昇格という大きな投資を行うのです。
なぜ段階的コンパイル(Tiering)が存在するのか: コンパイル処理はタダではありません。CPU時間をページの他の処理と奪い合うことになります。純粋なインタプリタは同じホットな命令を何度も再ディスパッチするのにサイクルを浪費し、純粋な最適化コンパイラはコンパイルコストを回収できるほど長く実行されないコードの高度な最適化にサイクルを浪費します。Maglevが存在する最大の理由は、そのトレードオフ曲線の「中間」を低コストにすることであり、TurboFanの高価な最適化処理を、統計的に価値があると証明されたコードだけに限定するためなのです。
TurboFan:最適化コンパイラ
関数が単に温かいだけでなく持続的にホットであると証明されると(TurboFanの重いコンパイルコストを支払っても十分なお釣りが来るほど呼び出されるかループ実行された場合)、V8はその関数を最上位の最適化JITコンパイラであるTurboFanに引き渡します。TurboFanはIgnitionとMaglevから蓄積された型フィードバックを受け取り、実際に観察された型に特化した、V8が生成し得る最もアグレッシブに最適化されたネイティブマシンコードを生成します。たとえば、関数の引数が常に小さな整数(small integer)であると仮定し、汎用的な実装で必要となる型チェックやボクシング/アンボクシングのオーバーヘッドを完全に排除します。
これは根本的に投機的最適化です。TurboFanは「過去の型の挙動が将来の型の挙動を予測できる」という賭けをしています。後からその賭けが破られた場合(常に整数を受け取っていた関数が突然文字列を受け取った場合など)、V8は**デ最適化(deoptimize)**を実行しなければなりません。特化されたマシンコードを破棄し、より低い階層(Maglevのコード、あるいは最終的にはIgnitionのバイトコード)へフォールバックした上で、後からより広い前提条件で再最適化を行うことになります。頻繁なデ最適化は、JavaScriptのパフォーマンス低下における最も一般的でありながら、最も目に見えにくい原因の1つです。
デ最適化の罠: ポリモーフィック(多態的)な呼び出し元(多数の異なるオブジェクト形状で呼び出される関数)、単一の配列内での型の混在、構造化後のオブジェクト構造の変更などは、実行途中でV8に最適化パスを諦めさせる(デ最適化を強制する)最も一般的な要因です。
隠しクラス(Hidden Classes):静的構造の疑似的実現
ここに根本的な問題があります。静的型付け言語では、コンパイラはコンパイル時にオブジェクトの各プロパティがメモリ上のどこに存在するのかを正確に把握しているため、obj.x は固定メモリセグメントへのオフセット読み込みとしてコンパイルされます。しかしJavaScriptでは、オブジェクトは動的な辞書型(ハッシュマップ)であり、プロパティはいつでも追加・削除できます。そのため、素直に実装するとプロパティアクセスのたびにハッシュマップ検索が必要になり、大規模な処理では壊滅的に遅くなってしまいます。
V8の解決策が**隠しクラス(Hidden Classes、エンジン内部ではMapと呼ばれますが、JSの Map 型とは異なります)**です。すべてのJavaScriptオブジェクトは、その現在の「形状(shape)」を表す隠しクラスと内部的に暗黙のうちに関連付けられています。隠しクラスには、どのプロパティが存在し、それぞれがどのオフセット位置に存在するかが記録されています。同じ順序でプロパティが追加されて構築された2つのオブジェクトが存在する場合、V8はそれらが同じ形状を共有していると認識し、同じ隠しクラスを割り当てます。これにより、プロパティアクセスを静的言語と同じように直接のオフセット読み込みとしてコンパイルできるようになります。
オブジェクトの形状が変化した瞬間(新しいプロパティの追加や削除)、V8はそのオブジェクトを新しい隠しクラスへと遷移(transition)させなければなりません。2つのコンストラクタが論理的に類似したオブジェクトを構築したとしても、プロパティを代入する順序が異なる場合、V8はそれらに対してまったく異なる隠しクラスの遷移チェーンを生成してしまい、この最適化が無効化されてしまいます。
インラインキャッシュ(Inline Caching):過去に認識した形状の記憶
隠しクラスはプロパティ検索がどのように行われるかを解決します。一方、**インラインキャッシュ(Inline Caching / IC)**は、コード上の特定のポイントにおいて検索がどれだけ高速に行われるかを解決します。すべてのプロパティアクセス箇所(「呼び出し元」、例えば obj.x という特定の行)は、前回確認した隠しクラスとそれに対応するメモリのオフセット値を記憶する小さなキャッシュを保持しています。同じ行が次に実行される際、V8は「このオブジェクトの隠しクラスは前回と同じか?」をチェックします。同じであれば、検索を完全にスキップしてキャッシュされたオフセット値へと直接ジャンプします。
インラインキャッシュは以下の3つの状態(ステート)を推移します:
- モノモーフィック(Monomorphic) — 呼び出し元が1種類の隠しクラスしか見たことがない状態。最も高速な実行パスです。
- ポリモーフィック(Polymorphic) — 呼び出し元が限定された少数(V8は数種類をキャッシュして個別にチェック)の異なる隠しクラスを見た状態。これでもまだ合理的に高速です。
- メガモーフィック(Megamorphic) — 呼び出し元が多種多様な形状を見すぎており、キャッシュが効果的に機能しない状態。V8はICの高速パスを諦め、汎用的で非常に低速なプロパティ検索へとフォールバックします。
ライブラリやスタイルガイドが一貫したオブジェクトの構築(固定されたプロパティセット、一貫した追加順序、delete の回避など)を強く推奨するのはまさにこれが理由です。これは単なるおまじないや信条ではなく、インラインキャッシュをモノモーフィックな状態に維持するための技術的な裏付けに基づいています。
3. クリティカルレンダリングパス:バイトからピクセルまで
V8がスクリプトを実行した後も、ブラウザはドキュメントとスタイルシートを実際の物理ディスプレイ上の画像へと変換しなければなりません。理想的には1秒間に60回(または120回)これを行います。このパイプライン――クリティカルレンダリングパス(Critical Rendering Path)――こそが、ネットワーク上のバイト列がピクセルへと変わる場所です。
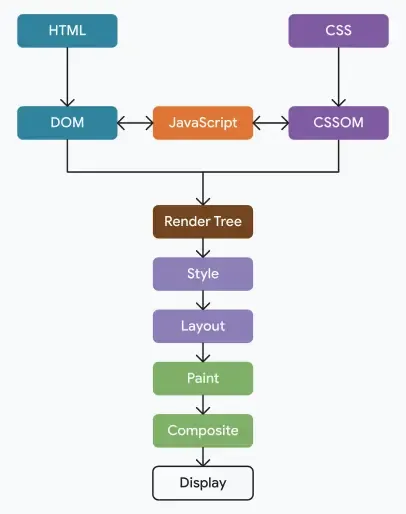
図3:クリティカルレンダリングパスのパイプライン。ブラウザはHTMLとCSSをパースしてDOMおよびCSSOMツリーを構築し、それらを結合してレンダリングツリー(Render Tree)を作成します。その後、レイアウト、ペイント、コンポジットの各パスを実行して最終的なフレームを画面に描画します。
DOMおよびCSSOMの構築
HTMLのバイト列が到着すると、BlinkのHTMLパーサーはそれを段階的にトークン化し、すべての要素とテキストノードの動的な構造化表現である**DOM(Document Object Model)**ツリーを構築します。パースは本質的にストリーミングかつ段階的(インクリメンタル)に行われます。ブラウザはツリーの構築を開始するのにドキュメント全体が届くのを待つことはありません。パーサーが到達する前に、**プリロードスキャナー(Preload Scanner)**がメインパーサーの先回りをして <img>、<link>、<script> タグを早期に検知し、ネットワークリクエストを開始するのはこのためです。
並行して、<style> ブロックや外部スタイルシートから読み込まれるCSSがパースされ、計算された詳細度(specificity)とカスケード解決が適用されたスタイル規則のツリーである**CSSOM(CSS Object Model)が構築されます。CSSOMの構築はレンダリングをブロック(render-blocking)**します。原理上、後続のスタイル規則が先行する規則を上書きする可能性があるため、ブラウザは完全なCSSOMが得られるまで安全に描画を開始できません(スタイルシートを小さく保ち、早期に読み込ませるべきという古典的なパフォーマンスのアドバイスはこれが理由です)。
レンダリングツリー、レイアウト、ペイント
DOMとCSSOMが用意されると、Blinkはそれらを結合して**レンダリングツリー(Render Tree)**を作成します。これは本質的にDOMと同じですが、実際に画面に表示されるノードのみに絞り込まれ(display: none の要素は完全に除外され、visibility: hidden の要素は占有領域を持つため含まれます)、最終的に計算されたスタイルが注釈付けされています。
レンダリングツリーは何を描画するかのみを把握しており、どこに描画するかは把握していません。レイアウト(Layout / 別名 reflow)はツリーを巡回し、ビューポートを基準としたすべてのノードの正確なボックスモデルの幾何学的数値(位置、幅、高さ、マージン)を計算します。これは本質的にグローバルな処理です。1つの要素の幅を変更すると、その兄弟要素や子孫要素すべての位置に波及して変更が生じる可能性があります。レイアウトがパイプラインの中で最もコストの高い段階の1つであり、タイトなループ内で繰り返し発生させること(offsetHeight を読み取ってからスタイルを書き込むといった交互の呼び出しを行うレイアウトスラッシング / layout thrashing)が典型的なパフォーマンスアンチパターンとされるのはこのためです。
幾何学的数値が決定すると、**ペイント(Paint)**は各表示要素を実際のピクセルへとラスタライズします。テキスト、色、境界線、シャドウ、画像などを塗りつぶし、レイヤーごとに順序付けされた描画コマンドのリスト(矩形、グリフ列、画像ブリットなど)として記録します。
コンポジット:GPUへの処理の引き渡し
最終段階である**コンポジット(Compositing)こそが、滑らかなスクロールやアニメーションを可能にしている技術です。特定の要素(CSSの transform、opacity のトランジション、will-change ヒントが設定されたもの、<video>、<canvas> など)は、独立したテクスチャである自身のコンポジタレイヤー(Compositor Layer)へと昇格します。これらのレイヤーはGPUプロセスに引き渡され、JavaScript/レイアウト/ペイントを行うメインスレッドとは完全に分離された専用のコンポジタスレッド(Compositor Thread)**上で合成(コンポジット)されます。
この利点は絶大です。transform や opacity のアニメーションはレイアウトやペイントを完全にスキップし、あらかじめラスタライズされたテクスチャの位置をGPU側で再配置するだけで処理できます。メインスレッドがJavaScriptの実行で高負荷状態であっても、これら2つのプロパティが滑らかな60/120fpsを維持できるのはまさにこのためです。対照的に、width、top、left などをアニメーションさせると、幾何学的数値そのものが変化するため、フレームごとに完全な レイアウト → ペイント → コンポジット のサイクルが毎回強制されてしまいます。
will-change は万能薬ではなくメスのように慎重に使うべき道具です: 要素を独自のコンポジタレイヤーへ昇格させるとGPUメモリを消費します(各レイヤーは完全なテクスチャとなるため)。多数の要素に will-change を乱用すると、GPUメモリを枯渇させ過剰なレイヤー管理を強いることになり、かえってパフォーマンスを損なう可能性があります。アニメーションが始まる直前に絞って適用し、終了後は削除するのが望ましい使用法です。
4. ウェブを押し進めるネットワークプロトコル:HTTP/1.1からHTTP/3へ
バイトデータの到着に時間がかかりすぎるようでは、いくらレンダリングを高速化しても意味がありません。ブラウザの背後にあるトランスポート層は、レンダリングエンジン自体と同ほどにラディカルな再設計を経験してきました。
HTTP/1.1と先頭ブロック化(Head-of-Line Blocking)問題
HTTP/1.1はプレテキスト(平文)によるリクエスト・レスポンスプロトコルであり、厳密には1つのTCP接続につき一度に処理できるリクエストは1つだけでした(パイプライン処理――応答を待たずに複数のリクエストを送信すること――は技術的には許可されていましたが、中継プロキシ間で実装が不適切かつ一貫していなかったため、ブラウザがデフォルトで有効にすることは一度もありませんでした)。何らかの並行処理を実現するため、ブラウザはオリジンごとに複数のTCP接続を同時に開くという手段に訴えました(通常は約6個に制限)。このハックは機能するものの、明確な代償を伴います。各接続は独自のTCPハンドシェイクを必要とし、HTTPSの場合はさらに独自のTLSハンドシェイクが必要となり、それぞれが遅い初期輻輳ウィンドウ(slow initial congestion window)からスタートします。
HTTP/2:単一接続上での多重化(Multiplexing)
HTTP/2は、HTTP/1.1のプレテキスト形式のフレーミングをバイナリフレーミング層に置き換え、リクエストとレスポンスをストリームIDが付加された小さなフレームへと分割し、それらすべてを単一のTCP接続上でインターリーブ(織り交ぜ)処理できるようにしました。これにより真の多重化が実現され、1つの接続上で数十件のリクエストとレスポンスを同時に進行させることができるようになり、6接続のワークアラウンドやそれに伴う冗長なハンドシェイクのオーバーヘッドが不要になりました。また、HTTP/2は(同一オリジンへのリクエスト間でHTTPヘッダーが極めて冗長であるため)HPACKヘッダー圧縮を導入し、さらに物議を醸した機能としてサーバープッシュも導入しました(これは正しく調整するのが難しく、<link rel="preload"> のようなよりシンプルな手法のほうが優れたパフォーマンスを発揮することが証明されたため、2022年までに実質的に放棄されました)。
HTTP/2はアプリケーション層の先頭ブロック化を解決しましたが、トランスポート層からより深刻な問題を継承しました。TCPは厳格な順序付き・順番通りのバイト配信を保証します。 共有されているその単一のTCP接続上でたとえ1つのパケットでも喪失すると、失われたパケットが再送されてバイトストリームの順序が復元されるまで、TCPはカーネルの受信バッファをアプリケーションへ引き渡さないため、多重化されているすべてのHTTP/2ストリームがストール(停止)してしまいます。失われたパケットが数十あるアクティブなストリームのうちのたった1つに属していたとしても同様です。これがトランスポート層の先頭ブロック化であり、背後にあるトランスポートがTCPである限り、アプリケーション層でどれほど巧妙な工夫を凝らしてもこれを修正することはできません。
HTTP/3:TCPを廃しQUICへ移行
HTTP/3の決定的な方針転換はラディカルです。TCPを完全に廃止し、UDPの上に構築された新しいトランスポートプロトコルであるQUIC上で動作します。これは一見すると後退のように思えるかもしれません。UDPには順序や信頼性の保証が一切ないためです。しかし、それこそがまさに狙いなのです。QUICは信頼性と輻輳制御をトランスポート層において自前で再実装していますが、重要なのは、接続全体ではなくストリームごとにそれを実行する点です。ストリーム4のデータを運ぶパケットが失われても、再送を待ってストールするのはストリーム4だけであり、ストリーム1、2、3はアプリケーションへのデータ配信を中断することなく継続します。先頭ブロック化の範囲は、データが実際に失われた個別のストリームに限定され、接続全体に波及することはなくなります。
また、QUICはトランスポートと暗号化のハンドシェイクを統合しています。従来、TCP + TLS 1.3ではTCPハンドシェイクの後に別のTLSハンドシェイクが必要でしたが(ラウンドトリップが増加する)、QUICはTLS 1.3を自身のハンドシェイクに直接統合しています。また、クライアントが最近訪れたサーバーへの再接続時には、0-RTT再開をサポートします。クライアントは、前回のセッションからキャッシュされた暗号パラメータを使用することで、サーバーのラウンドトリップの完了を一切待たずに、最初のパケット送信の段階で暗号化されたアプリケーションデータを送信できます(0-RTTデータには理論上のリプレイ攻撃リスクが伴うため、サーバー側でどの種類のリクエスト、通常は冪等なリクエストのみに利用を許可するかを制限しています)。
もう1つの過小評価されがちなQUICの機能がコネクションマイグレーションです。QUIC接続は、従来のTCPの4タプル(送信元IP、送信元ポート、宛先IP、宛先ポート)ではなくコネクションIDによって識別されるため、クライアントは外出時にWi-Fiからモバイルデータ通信へとネットワークを切り替えても、接続を切断して再確立することなくそのまま維持できます。
| プロパティ | HTTP/1.1 | HTTP/2 | HTTP/3 |
|---|---|---|---|
| トランスポート | TCP | TCP | UDP上のQUIC |
| 多重化 | なし(複数接続が必要) | あり、単一接続 | あり、ストリームごと |
| 先頭ブロック化 | 深刻(接続単位) | トランスポート層のみ(1つのパケットロスで全ストリームが停止) | 排除(ストリームごとに独立) |
| ヘッダー圧縮 | なし | HPACK | QPACK |
| ハンドシェイク | TCP + 個別のTLSハンドシェイク | TCP + 個別のTLSハンドシェイク | 統合されたトランスポート + 暗号化ハンドシェイク |
| 0-RTT再開 | なし | なし | あり |
| コネクションマイグレーション | なし(IP/ポートに紐付け) | なし(IP/ポートに紐付け) | あり(コネクションIDベース) |
UDPは万国共通で歓迎されているわけではありません: QUICはUDP上で動作するため、一部の企業のファイアウォール、古いミドルボックス、制限の厳しいネットワークでは、歴史的にTCPを優先または想定するように調整されてきたため、UDPをスロットリング(帯域制限)したり完全にブロックしたりすることがあります。ブラウザはこの問題に対処するため、日頃から日和見的にHTTP/3の接続を試みつつ、UDPが利用できない場合は透過的にTCP上のHTTP/2へフォールバックする仕組みをとっています。この優雅な劣化(グレイスフルデグラデーション)のパスは、想定に頼るのではなく、クライアント側に組み込んでおく必要があります。
5. 結論:WebAssemblyとネイティブとのギャップの埋め込み
ここまでに解説してきたすべてのレイヤー――サンドボックス化されたマルチプロセスアーキテクチャ、V8の投機的JIT、GPUアクセラレーションによるレンダリングパイプライン、そしてQUICの低遅延トランスポート――は、すべて「ブラウザを第一級のアプリケーションプラットフォームのように振る舞わせる」という1つの目的のために構築されました。最後の大きなギャップは、動画/写真編集スイート、CADツール、フル3Dゲームエンジン、科学技術計算といった最重量級のワークロードにおける純粋な計算スループットでした。これらにおいては、V8の最適化されたマシンコードであっても、JavaScriptの動的型チェックやガベージコレクションの停止に起因する残留オーバーヘッドを抱えてしまいます。
**WebAssembly(Wasm)**はそのギャップを埋める技術です。Wasmは、手書きされる言語ではなくコンパイルのターゲットとして設計された、コンパクトなバイナリ命令フォーマットです。C、C++、Rust、GoなどのコードはWasmモジュールへと直接コンパイルでき、同じサンドボックス化されたレンダラープロセス内でネイティブマシンコードに近い速度で実行されます。Wasmは静的型付けであり事前検証(AOT)が行われるため、JavaScriptエンジンが予測(スペックュレーション)しなければならない動的型付けのオーバーヘッドを回避できるからです。WasmモジュールはJavaScriptと線形メモリバッファを共有し、軽量なJSグルーコードを介して呼び出されます。これにより、物理エンジン、動画コーデック、CADカーネルといった既存のネイティブコードベースを、大掛かりな修正なしにブラウザ上にそのまま持ち込むことが可能になります。
これこそが、Figmaがタブ内でC++レンダリングエンジンを動かしている仕組みであり、AutoCADやPhotoshopが実用的な編集パフォーマンスを備えたブラウザ版を提供できる理由であり、Unreal EngineやUnityがウェブをプレイ可能なゲームデモのビルドプラットフォームとしてターゲットにできる理由です。**WebAssembly System Interface(WASI)**のような新たな取り組みは、現在、Wasmのサンドボックス化されたポータブルな実行モデルをブラウザの外部へ完全に応用し、エッジコンピューティングやサーバーサイドのランタイムへと拡張しています。これにより、ブラウザのパフォーマンス問題を解決するために生まれた技術が、あらゆるコンピューティングに向けた汎用的かつ安全な実行フォーマットへと進化を遂げています。
ネットスケープがドキュメントビューアを世に送り出してから30年、今日「ブラウザ」はおそらく、ほとんどの人が日常的に実行するソフトウェアの中で最も洗練されたものとなっています。それはエンジニアリングの真の意味において、あなたのスクリーンの長方形の中にたまたま自身を描画している、1つのオペレーティングシステムに他なりません。
参考文献および詳細な読書案内
- V8 Development Team. Firing up the Ignition interpreter. V8.dev. Ignitionのバイトコード設計とV8の起動パフォーマンスにおける役割に関する技術的背景。
- V8 Development Team. TurboFan JIT Design. V8.dev. V8の最適化コンパイラおよび投機的最適化モデルに関するアーキテクチャ文書。
- Chromium Project. Site Isolation Design Documents. Chromium.org. Spectreの脆弱性開示に続く、サイトごとのレンダラープロセス分離に関するエンジニアリング上の設計根拠。
- IETF. RFC 9000: QUIC — A UDP-Based Multiplexed and Secure Transport. IETF Datatracker. HTTP/3の基礎となる公式のQUICトランスポート仕様。
- IETF. RFC 9114: HTTP/3. IETF Datatracker. QUICトランスポート上へのHTTPセマンティクスの公式なマッピング。
- web.dev (Google). Critical Rendering Path. web.dev. DOM/CSSOMの構築、レイアウト、ペイント、コンポジットに関するリファレンスドキュメント。
- WebAssembly Community Group. WebAssembly.org. Wasmバイナリ命令フォーマットの公式仕様ハブおよび設計根拠。
テクニカルグロッサリ
| 用語 | 定義 |
|---|---|
| Blink | 2013年にWebKitからフォークされたGoogleのHTML/CSSレンダリングエンジン。現在ではChrome、Edge、Opera、およびその他の多くのChromiumベースのブラウザで共有されています。 |
| サイト分離(Site Isolation) | Spectreクラスのメモリ読み出し攻撃から防御するため、クロスオリジンのiframeも含め、異なるサイトごとに独自のレンダラープロセスを割り当てるChromiumのセキュリティアーキテクチャ。 |
| Ignition | V8のバイトコードインタプリタ。高速な起動実行と、型フィードバックプロファイルデータの収集を担当します。 |
| TurboFan | V8の最適化JITコンパイラ。「ホット」な関数に対して、投機的に型特化したネイティブマシンコードを生成します。 |
| 隠しクラス(Map / Hidden Class) | JavaScriptオブジェクトのプロパティの「形状(shape)」を表すV8の内部表現。静的言語のようなオフセットベースのプロパティアクセスを可能にします。 |
| インラインキャッシュ(Inline Cache / IC) | 最後に観測された隠しクラスを記憶する呼び出し元ごとのキャッシュ。再実行時にV8が完全なプロパティ検索をスキップできるようにします。 |
| CSSOM | CSS Object Model(CSSオブジェクトモデル)。パースされたスタイルシート規則のツリー表現であり、DOMと結合されてレンダリングツリーを生成します。 |
| コンポジタスレッド(Compositor Thread) | メインのJS/レイアウトスレッドから独立した専用スレッド。メインスレッドの作業とは無関係に滑らかなアニメーションを実現するため、GPUレイヤーの合成を処理します。 |
| 先頭ブロック化(Head-of-Line Blocking) | 1つのデータユニットの損失や遅延が、同じチャンネル上で多重化されている無関係なデータの配信をブロックしてしまうストール状態。 |
| QUIC | ストリームごとの信頼性、統合されたTLS 1.3ハンドシェイク、0-RTT再開、コネクションマイグレーションを提供するUDPベースのトランスポートプロトコル(RFC 9000)。 |
| 0-RTT再開(0-RTT Resumption) | 再訪したクライアントが、サーバーのラウンドトリップを待たずに、最初のパケット送信(packet flight)で暗号化されたアプリケーションデータを送信できるようにするQUIC/TLS 1.3の機能。 |
| WebAssembly (Wasm) | ブラウザランタイム内でネイティブに近いパフォーマンスを実現するためのコンパイルターゲットとして使用される、静的型付けのサンドボックス化されたバイナリ命令フォーマット。 |