索尼的 PlayStation 3 于 2005 年亮相并于 2006 年 11 月正式发售,其核心驱动力来自于联合 IBM 和东芝耗资 4 亿美元共同研发的 Cell Broadband Engine 架构。凭借宣称的万亿次(Teraflop)浮点运算吞吐量、实时超级计算能力以及绝对的跨时代统治力,该硬件曾承诺能让复杂的现代物理演算变得轻而易举。然而,当 Rockstar Games 于 2008 年 4 月推出《侠盗猎车手IV》(Grand Theft Auto IV)时,底层程序员面对的绝非一台轻而易举的超级计算机,而是消费电子产品史上最棘手、最不友好的内存与执行模型之一。
微软的 Xbox 360 提供了一个舒适的对称多核环境,可以在灵活统一的 512 MB RAM 池中运行标准 C++ 多线程代码;相比之下,PlayStation 3 则是一个极其激进的工程异类。为了赋予自由城(Liberty City)生命力,开发团队必须经历彻底的范式转变:将高频刚体物理演算、通过 NaturalMotion 的 Euphoria 引擎实现的过程角色动画(procedural character animation)以及持续的资源流式加载,全部迁移并适配到这种激进的非对称架构中。
本文将从系统层面深度剖析 Rockstar Games 的 RAGE 引擎如何征服 Cell 处理器:1 个 PPE + 6 个 SPE 的任务分发管道、通过异步直接内存访问(DMA)管理 256 KB Local Store 限制的残酷工程细节,以及 PS3 独立内存(split-memory)瓶颈所迫使引擎做出的视觉妥协。
1. 超级计算机的幻想:PS3 的异构现实
Cell Broadband Engine 从根本上说是一个围绕非对称多处理设计的向量处理管道。其中心是一个独立的 PPE(Power Processing Element,Power 处理元素)——一个主频为 3.2 GHz 的双线程 64 位 PowerPC 核心。围绕 PPE 的是 8 个 SPE(Synergistic Processing Element,协同处理元素),它们是运行在相同时钟频率下的精简型向量协处理器,每一个都包含一个 SPU(Synergistic Processing Unit,协同处理单元) 和被称为 Local Store(LS,局部存储) 的 256 KB 专用本地内存空间。为了提高芯片良品率,工厂出厂时永久禁用了一个 SPE,而第二个 SPE 被索尼的 Hypervisor / GameOS 独占预留,最终只给开发者留下了刚好 6 个可用的 SPE 用于通用计算工作负载。
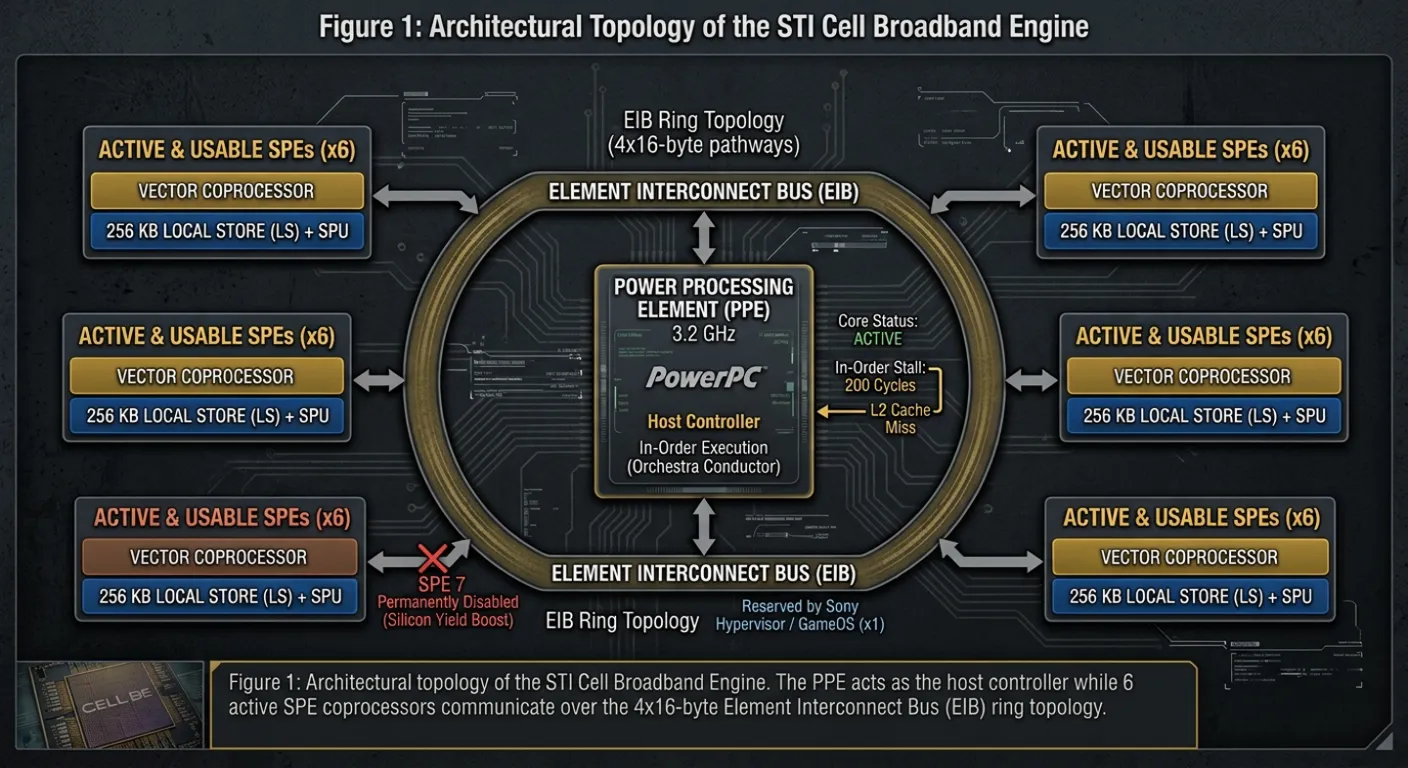
图 1:STI Cell Broadband Engine 的架构拓扑。PPE 充当主机控制器,而 6 个活跃的 SPE 协处理器通过 4x16 字节的元素互连总线(EIB)环形拓扑结构进行通信。
这套架构的理论计算能力惊人。单个 SPE 利用其 128 位 SIMD 寄存器,每个时钟周期最多可执行 4 次单精度浮点运算:
在全部 6 个可用 SPE 上,裸向量性能达到了:
当与 PPE 的向量处理单元(Altivec/VMX)结合时,该芯片宣称拥有约 200 GFLOPS 的理论性能。然而,这一理论计算峰值却被一个严重的架构隐患所封印:PPE 核心是一个按序执行(In-Order Execution)引擎。
按序执行的陷阱: 现代桌面 CPU(以及某种程度上的 Xbox 360 Xenon 核心)依赖乱序执行(OoOE)在发生内存停顿和缓存未命中时动态重新调度指令。PS3 的 PPE 则没有这种奢侈待遇。如果运行在 PPE 上的线程遭遇 L2 缓存未命中,整个流水线将彻底停顿长达 200 个时钟周期。带有深度指针追溯(pointer-chasing,在游戏引擎的 C++ 对象图谱中极具代表性)的标准 C++ 代码在 PPE 上的运行速度慢得令人发指。
因此,PPE 充其量只能被视作一个乐队指挥。如果开发者试图将经典的单体式 C++ 游戏循环、AI 决策树、渲染准备工作以及物理模拟完全运行在 PPE 上,PS3 的运行速度甚至比中端 Pentium 4 还要慢。为了榨干其性能,游戏系统必须经过彻底拆解、向量化,并卸载(offload)到自主运行的 SPE 协处理器上。
2. 非对称多线程:卸载 Euphoria 与车辆物理
Xbox 360 拥有三个对称的 PowerPC 核心(6 个硬件线程),可以平等地访问共享 L2 缓存和统一内存。尽管 Xenon 核心同样是按序执行引擎,但得益于共享且具备缓存一致性(cache-coherent)的内存层级,标准的多线程范式——例如通过线程池或 OpenMP 将工作负载拆分到传统线程中——能够自然而然地流畅运行。
然而在 PS3 上,这套模型彻底崩塌。SPE 并不是通用核心。它们没有用于支持标准指针加载/存储(load/store)操作的硬件 L1/L2 数据缓存兜底,没有标准的分支预测硬件,也与标准的 PowerPC/x86 代码没有任何指令集兼容性。传统的 C++ 线程根本无法直接分发(dispatch)给 SPE 执行。
为了运行《侠盗猎车手IV》,Rockstar 的 RAGE(Rockstar Advanced Game Engine)团队必须将其物理和动画流水线重构为任务管理器(Job-Manager)模型。
将 Euphoria 和刚体物理卸载至 SPE
《GTA IV》为开放世界游戏引入了两套革命性的系统:
- 过程动画(NaturalMotion Euphoria): Euphoria 没有采用播放预制(pre-baked)死亡动画的做法,而是实时合成生物力学级别的运动控制响应。它模拟了中枢神经系统反射、肌肉张力、平衡约束以及骨骼动量。
- 车辆动力学与碰撞物理: 涵盖高频射线检测(raycast)悬挂建模、轮胎摩擦力曲线、软体形变以及数十辆活跃车辆的高复杂度刚体碰撞。
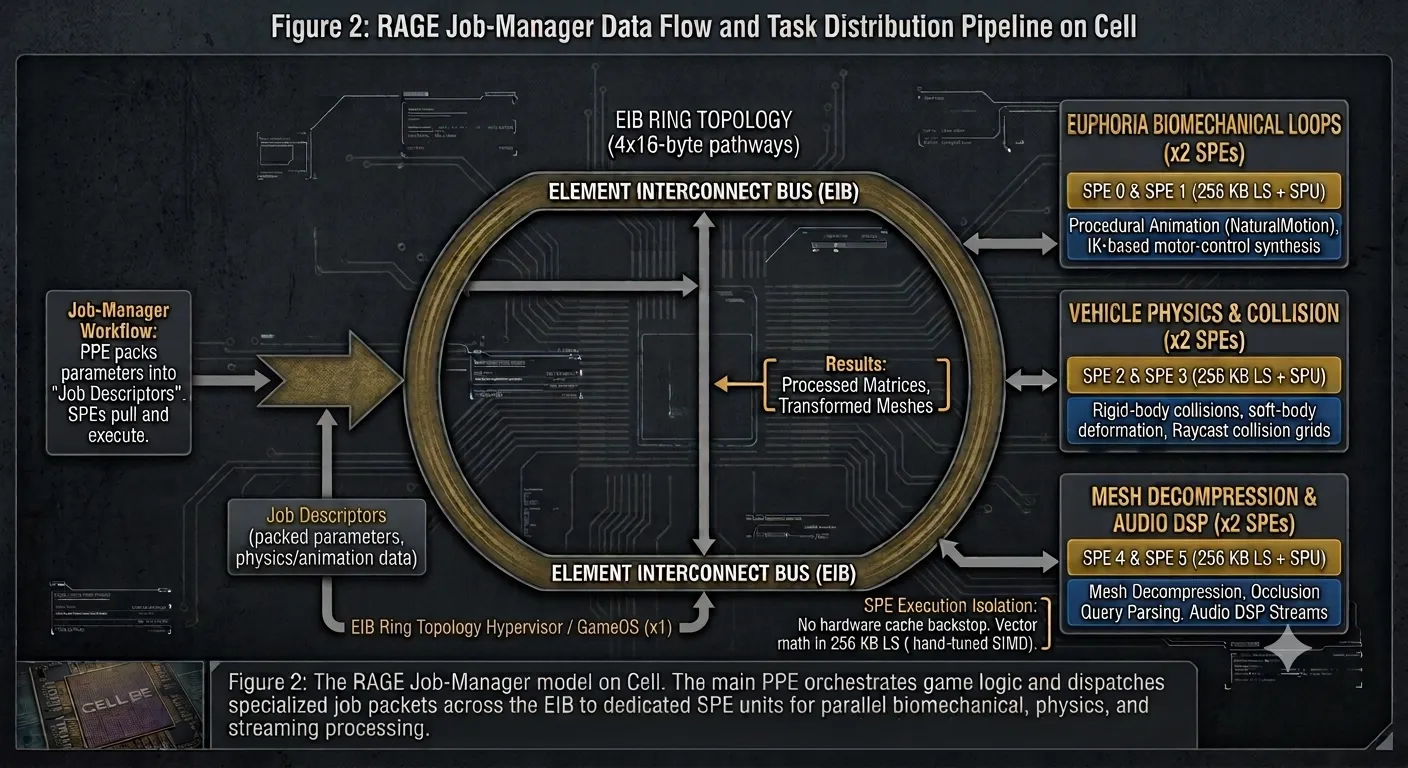
图 2:Cell 上的 RAGE 任务管理器模型。主 PPE 统筹游戏逻辑,并通过 EIB 向专用 SPE 单元分发特化的任务包(job packets),以实现生物力学、物理和流式传输的并行处理。
由于这些计算在数学上极其密集、具备确定性且可向量化,因此成为了卸载至 SPE 的绝佳对象。
- PPE 职责: 管理游戏玩法逻辑、任务脚本、高层 AI 寻路、音频混音路由以及操作系统调用。它将模拟参数打包成轻量级的“任务描述符”(Job Descriptors)。
- SPE 职责: 拉取任务描述符,在隔离环境中执行纯向量数学运算,并返回变换后的矩阵。SPE 0 与 SPE 1 运行 Euphoria 生物力学循环;SPE 2 与 SPE 3 处理车辆物理和射线检测碰撞网格;SPE 4 与 SPE 5 负责网格解压缩、遮挡查询解析以及音频 DSP 流。
SPE 上的 Euphoria: 实时模拟人体生物力学需要在每一帧(33.3 ms)内求解复杂的逆运动学(IK)和多体刚体动力学。利用手写调优的 SIMD 向量寄存器,单个 SPE 能在微秒级时间内计算出整个角色的肌肉反应,从而将 PPE 从数十万次矩阵变换中彻底解放出来。
3. 256 KB Local Store 地狱与手动 DMA 管道配置
Cell 处理器上最残酷的单一瓶颈莫过于内存隔离。SPE 无法 直接读取 PS3 的 256 MB 主内存(XDR)或 256 MB 显存(GDDR3)。
相反,每个 SPE 只能执行物理上完全位于其自身 256 KB Local Store 内部的代码并读写其中的数据。这 256 KB 的内存空间由可执行代码(微码二进制程序)、栈(stack)以及数据缓冲区共同瓜分。
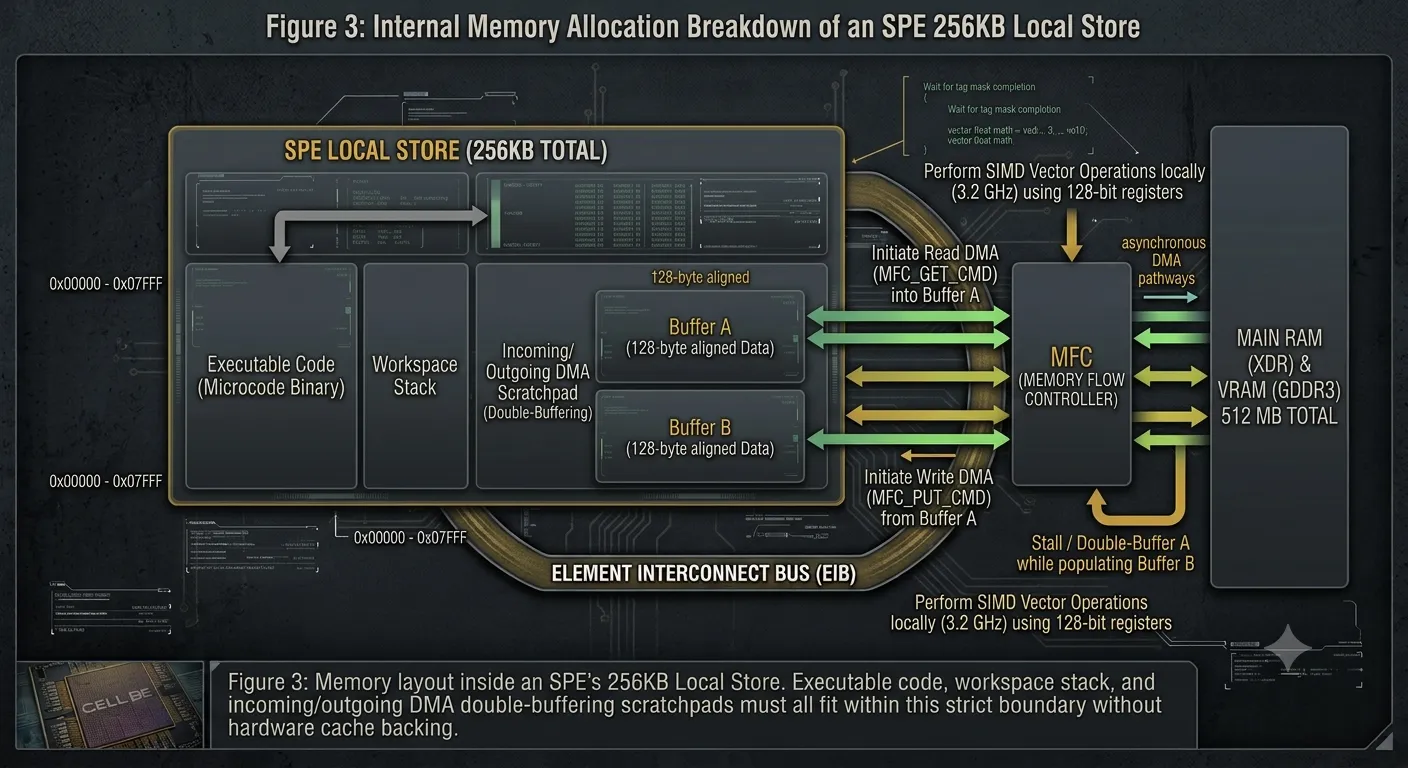
图 3:SPE 256KB Local Store 内部的内存布局。可执行代码、工作区栈以及用于输入/输出 DMA 双缓冲的暂存缓冲区都必须容纳在这条严格的界限之内,且没有任何硬件缓存支持。
SPE 上没有任何由硬件管理的 L1 或 L2 数据缓存来静默地从主内存中拉取缺失的数据块。如果 SPE 程序请求了一个位于其 256 KB Local Store 之外的内存地址,硬件不会自动去抓取——它根本无法对该地址进行寻址。
异步 DMA 传输的运作机制
为了在 SPE 上处理网格(mesh)、碰撞树(collision tree)或布娃娃系统(ragdoll)实例,开发者必须编写手动的 直接内存访问(DMA) 指令,发送给挂载在每个 SPE 上的 内存流控制器(MFC,Memory Flow Controller) 接口。
数据流水线按照严格的异步模式运行:
- 发起读取 DMA: 指示 MFC 通过元素互连总线(EIB)将主 XDR 内存中的数据块拉取到 Local Store 缓冲区 A 中。
- 停顿或双缓冲: SPE 等待标签组完成掩码信号(Tag Group Completion Mask Signal),或者在缓冲区 A 填充数据的同时,对 Local Store 缓冲区 B 进行计算。
- 执行向量运算: 利用 128 位 SIMD 寄存器,以全速处理器频率(3.2 GHz)在本地处理数据。
- 发起写入 DMA: 发出 MFC 请求,将计算好的结果写回到主 XDR 内存或显存(VRAM)中。
为了防止 SPE 在 DMA 传输期间处于闲置状态,Rockstar 采用了双缓冲技术。当 SPE 在缓冲区 A 上执行处理时,MFC 会同时通过元素互连总线(EIB)将传入的 DMA 数据流式传输到缓冲区 B 中。这使执行单元始终保持饱和运转,但也需要将原本就极其狭小的 256 KB 空间拆分为更小的子暂存区(sub-scratchpads)。
4. 独立内存瓶颈:PS3 vs. Xbox 360
尽管处理器流水线带来了软件架构上的挑战,但物理内存限制则直接迫使 PS3 版《GTA IV》在图形和渲染方面做出了硬性的妥协。
| 硬件规格 | 微软 Xbox 360 | 索尼 PlayStation 3 |
|---|---|---|
| 系统总内存 | 512 MB 统一 GDDR3 | 512 MB 独立分区 |
| 系统内存分配 | 动态共享(例如 300 MB 显存 / 212 MB 系统内存) | 固定: 256 MB XDR 主内存 + 256 MB GDDR3 显存 |
| 主内存带宽 | 22.4 GB/s(至主系统) | 25.6 GB/s(XDR 主内存) |
| GPU 内存带宽 | 22.4 GB/s(统一) | 20.8 GB/s(GDDR3 显存) |
| eDRAM / 子芯片 | 10 MB 子芯片(高速 MSAA 填充率) | 无 |
| 总线拓扑 | 灵活的统一互连 | 严格的分割总线架构 |
独立内存陷阱
Xbox 360 允许游戏开发者灵活分配其 512 MB 的统一内存池。如果像《GTA IV》这样的游戏在流式传输时需要更多的几何体和系统状态内存,开发者可以将 320 MB 分配给系统内存,将 192 MB 分配给纹理和渲染目标。
PS3 则强制施行了一道僵硬的硬分区高墙:
- 256 MB XDR 系统内存(保留给 CPU、SPE 和游戏状态的超高速、低延迟内存)。
- 256 MB GDDR3 显存(严格专用于 RSX GPU 渲染目标和纹理贴图)。
如果 RSX GPU 在高密度场景中耗尽了显存,它在技术上可以通过 FlexIO 总线跨界访问主 XDR 内存,但跨越这条桥梁进行读取会带来巨大的带宽惩罚。此外,如果运行在 PPE 上的游戏逻辑需要超过 256 MB 的主内存,无论 256 MB 的显存池空闲多少,它都无法从中借用哪怕一 KB 的空间。
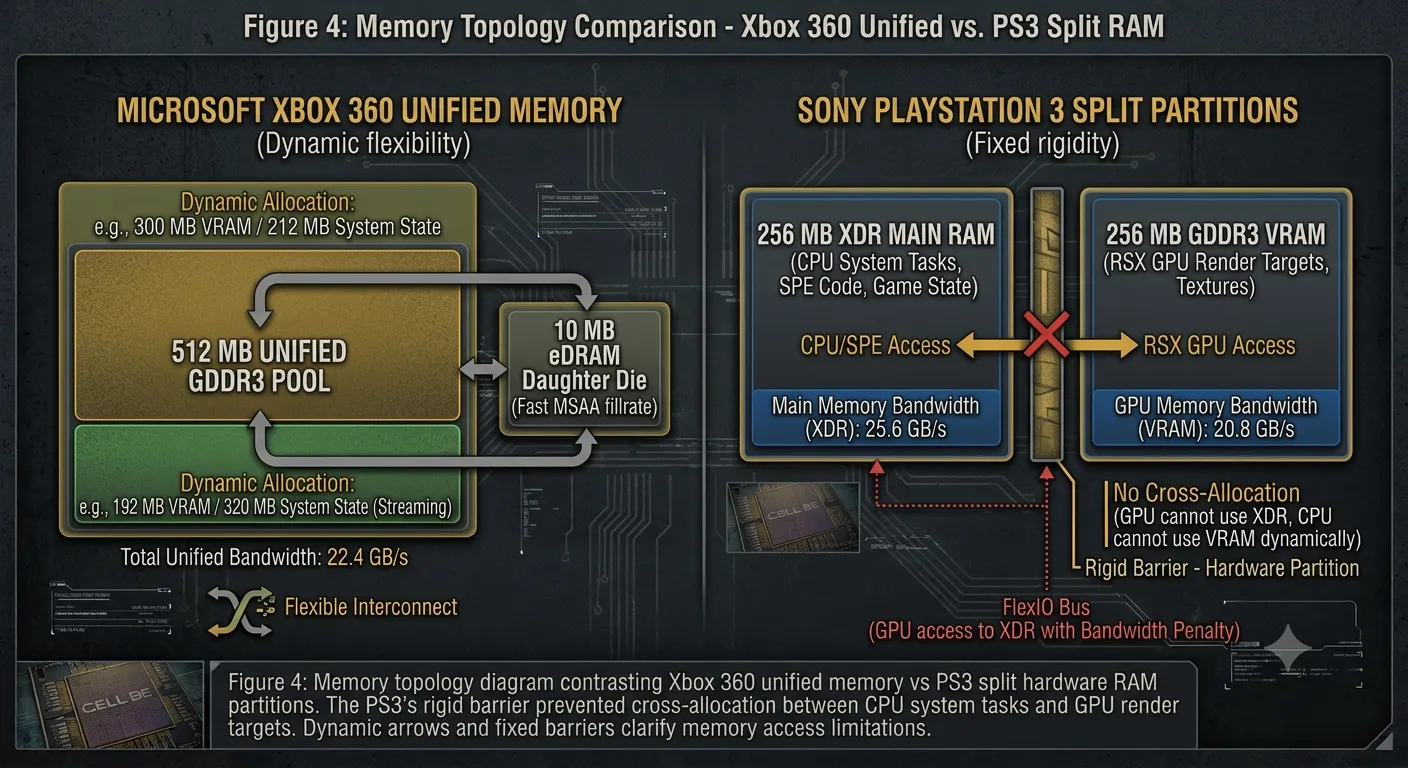
图 4:对比 Xbox 360 统一内存与 PS3 独立硬件内存分区的内存拓扑图。PS3 僵硬的隔阂阻止了 CPU 系统任务与 GPU 渲染目标之间的跨区分配。动态箭头和固定屏障清晰展示了内存访问限制。
640p 渲染妥协与模糊滤镜
这种僵硬的分区对 PS3 上《GTA IV》的渲染流水线产生了直接的后果:
- 缺乏用于抗锯齿的 eDRAM: Xbox 360 GPU 在 GPU 芯片上直接集成了 10 MB 专用 eDRAM 模块,能够以几乎为零的填充率成本执行 2x 或 4x 多重采样抗锯齿(MSAA)。而 PS3 的 RSX GPU(基于 NVIDIA 的 G70 架构)则完全缺乏 eDRAM。在 720p 分辨率下运行原生 2x MSAA 会消耗宝贵的显存并严重破坏帧率。
- 降低渲染分辨率: 为了在管理帧缓冲区目标、深度缓冲区和动态阴影贴图显存分配的同时维持 30 FPS 的目标帧率,Rockstar 不得不降低 PS3 的帧输出分辨率:
- Xbox 360 分辨率: 原生 1280x720 (720p) 并开启 2x MSAA。
- PS3 分辨率: 原生 1152x640 (640p) 且无硬件 MSAA。
- 软件抗锯齿与后处理模糊: 为了掩盖将 640p 图像放大到 720p 或 1080p 显示器时产生的严重锯齿瑕疵,Rockstar 在 PS3 上引入了较重度的后处理屏幕空间模糊滤镜。虽然这成功减弱了边缘锯齿,但相比 Xbox 360 版,也让 PS3 版本呈现出特有的更柔和、明显更“模糊”的视觉画面。
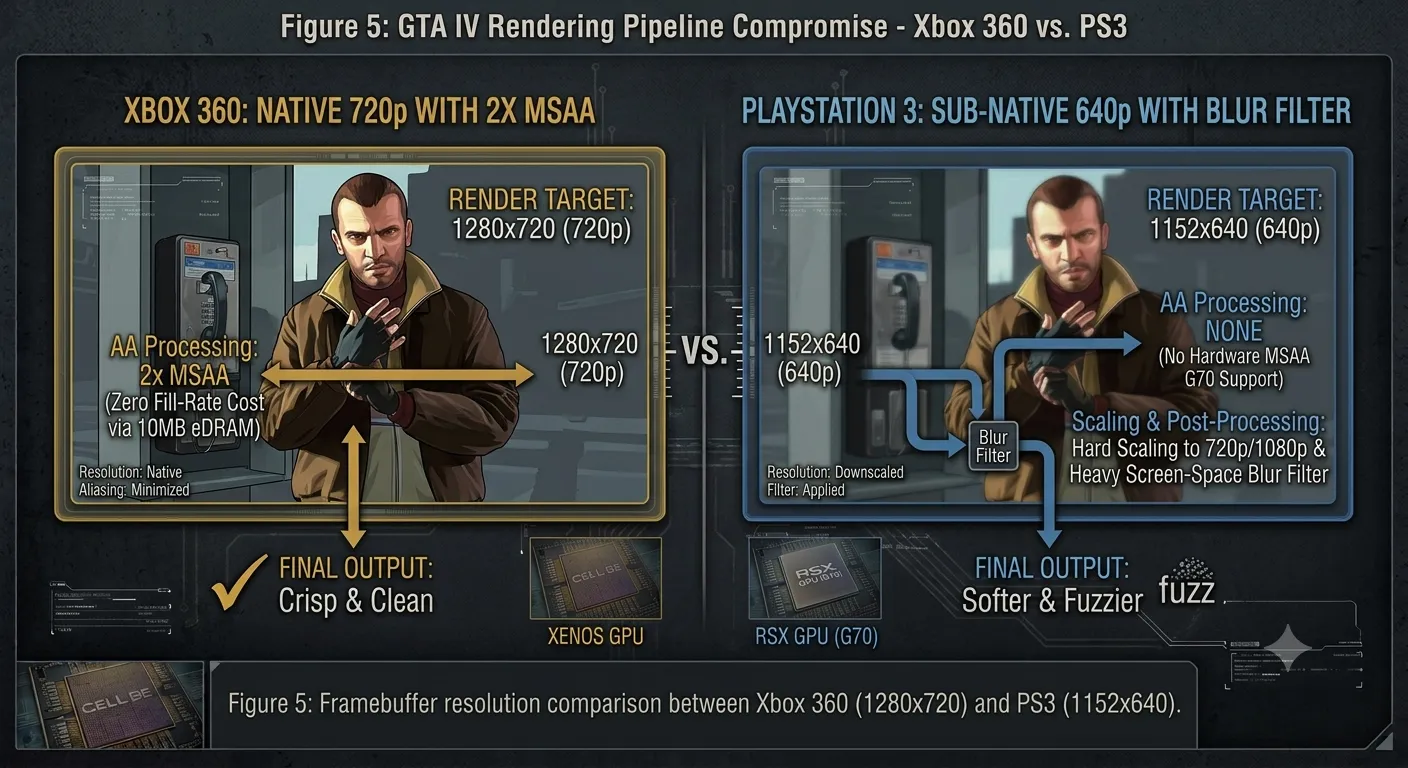
图 5:Xbox 360(1280x720)与 PS3(1152x640)之间的帧缓冲区分辨率对比。
5. 总结:裸机适配的终极范本
PlayStation 3 上的《侠盗猎车手IV》(Grand Theft Auto IV)依然是第七世代主机中最瞩目的技术成就之一。表面上看,这似乎只是一份分辨率稍低的移植版本,但在引擎盖之下,它却是对现代游戏引擎执行流水线的一次彻底重构。
Rockstar Games 拿下一套摒弃了现代标准编程范式的架构,并硬生生将其驯服。他们放弃了传统的抽象高层 C++ 架构,设计了定制的 DMA 驱动微码流水线,将复杂的生物力学过程数学演算卸载给 6 个独立的向量协处理器,并成功征服了现代游戏史上最为苛刻的内存拓扑结构之一。
Cell Broadband Engine 最终退出了历史舞台——未来的主机世代无一例外地采用了统一内存架构与对称 x86-64 多核 CPU。然而,将自由城塞进 256 KB Local Store 所积累的架构经验,却为当今整个行业广泛使用的现代任务系统(job-system)调度器、计算着色器(compute-shader)流水线以及底层显式图形 API(Vulkan、DirectX 12)铺平了道路。
参考文献与拓展阅读
- Gschwind, M. (2006). Chip Multiprocessing with the Cell Broadband Engine. IEEE Micro Journal. 深度技术解构 PPE、SPE 及 EIB 环形总线规范。
- Riley, M. W., Warnock, J. D., & Wendel, D. F. (2007). Cell Broadband Engine Processor: Design and Implementation. IBM Journal of Research and Development, 51(5), 545–557. 关于 Cell BE 处理器的电路设计、SoC 实现以及制造约束的全面技术论文。
- Wikipedia. Euphoria (software). NaturalMotion 的动态运动合成(Dynamic Motion Synthesis)中间件、实时过程动画及其在《侠盗猎车手IV》中与 Rockstar RAGE 引擎源代码集成的技术背景。
- PS3Dev Wiki Archives. Cell Broadband Engine and RSX Hardware Specifications. 社区保存的底层硬件文档、DMA 寄存器布局与内存映射。
技术词汇表
| 术语 | 定义 |
|---|---|
| Cell Broadband Engine | 由索尼、东芝和 IBM (STI) 联合研发的高性能异构微处理器,为 PlayStation 3 主机提供核心动力。 |
| PPE (Power Processing Element) | Cell 处理器上的主要通用 64 位 PowerPC 双线程核心,主频为 3.2 GHz。 |
| SPE (Synergistic Processing Element) | Cell 处理器上 8 个专用的独立向量协处理器单元之一,针对高吞吐量单精度 SIMD 向量运算进行了深度优化。 |
| Local Store (LS) | 每个 SPE 本地专用的 256 KB 超高速 SRAM 地址空间,用于存放可执行微码和计算数据缓冲区。 |
| DMA (Direct Memory Access) | 通过内存流控制器(MFC)执行的硬件介导异步内存传输命令,用于在主内存与 Local Store 之间移动数据块。 |
| EIB (Element Interconnect Bus) | 连接 PPE、SPE、内存控制器和 GPU 接口的高带宽内部环形总线,带宽高达 204.8 GB/s。 |
| Euphoria Engine | 由 NaturalMotion 开发的过程动画合成运行时,可实时计算生物力学运动动力学和物理响应。 |
| RSX ‘Reality Synthesizer’ | 由 NVIDIA 联合开发的 PS3 图形处理器(基于 NV47/G70 架构),运行频率为 550 MHz,配备 256 MB GDDR3 显存。 |
| XDR DRAM | 用作 PS3 主系统内存(256 MB)的极低延迟 Rambus DRAM,运行在 64 位总线上,提供 25.6 GB/s 的带宽。 |
| In-Order Execution | 按序执行。一种 CPU 流水线设计,指令严格按顺序处理,无需硬件层面的动态重新排序,在发生内存延迟时会导致严重的流水线停顿。 |